

近年来,随着以OpenAI GPT模型为代表的语言模型的兴起,开放域语言生成领域吸引了越来越多的关注,开放域中的条件语言生成效果令人印象深刻。促成这些进展的除了Transformer架构的改进和大规模无监督训练数据的使用外,更好的解码方法也发挥了不可或缺的作用。
基于搜索的解码方法
基于搜索的解码算法的时间复杂度、空间复杂度都非常高,目前常用的解码方法有贪心搜索(Greedy Search)、集束搜索(Beam Search)等。这些方法的核心目标是在每一步选择中寻找最优或近似最优的路径,以生成概率最大的文本序列。
1.贪心搜索:
贪心搜索算法在每个时间步t都选取当前概率分布中概率最大的词,作为输出,数学表达式如下:
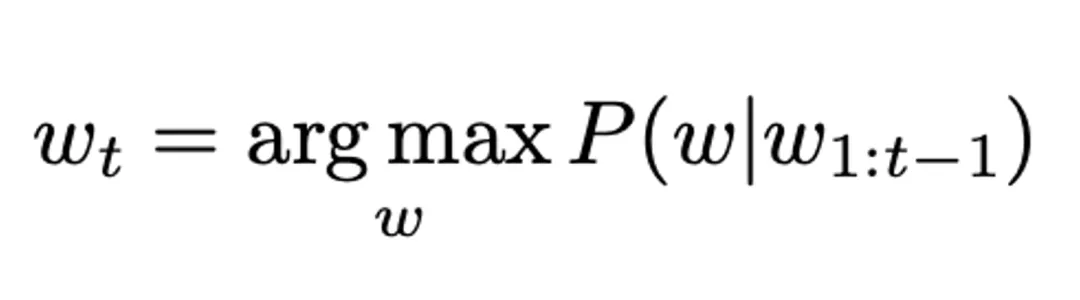 公式6.3
贪心搜索的一个缺点是,模型解码出的文本比较单一,并且有可能会陷入不断重复的死循环中,即模型解码出某一个词后,后面解码出的词便开始自我重复,这在语言生成中是一个非常普遍的问题,在贪婪搜中出现的概率似乎比较高。贪心搜索的另一个缺点是,它可能错过隐藏在低概率词后面的其他高概率词,如图6.1所示,条件概率为0.9的单词“有”隐藏在单词“狗”后面,而“狗”因为在t=1时条件概率值只排第二所以未被选择,因此贪心搜索会错过序列(“这”,“狗”,“有”)
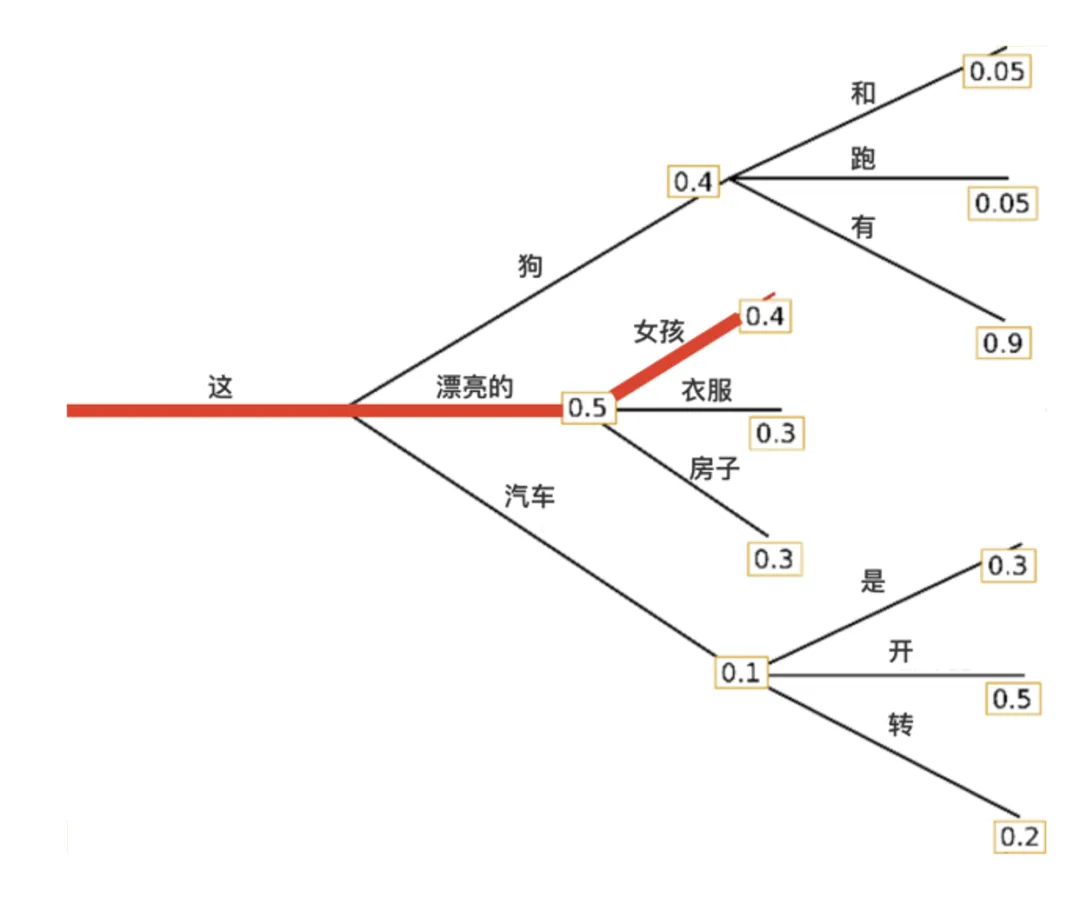 图6.1 贪心搜索示例
2.集束搜索
集束搜索是对贪心搜索的改进,它通过引入束宽参数B来扩大搜索范围。在每个时间步,集束搜索保留最可能的B个候选序列,而不是只保留一个。虽然集束搜索的搜索范围远远不及穷举搜索,但它覆盖了大部分概率较高的文本,因此在搜索方法中被广泛使用。集束搜索有一个关键的超参数“束宽”(Beam Size),一般用B表示。集束搜索通过在每个时间步保留最可能的B个词,并从中最终选择出概率最高的序列,从而降低丢失潜在的高概率序列的风险。
集束搜索一般都会找到比贪心搜索概率更高的输出序列,但仍不保证找到全局最优解。贪心搜索可以看作B=1的集束搜索,集束搜索是一种牺牲时间换性能的方法。无论是贪心搜索还是集束搜索,都在实现最大似然的搜索目标,即要求生成的文本有最高的概率。
对开放域文本生成来说,集束搜索也存在局限性:
(1)在开放域生成长文本时,集束搜索已被证明存在重复生成的问题。在故事生成这样的场景中,很难用N-gram或其他惩罚来控制,因为在“不重复”和最大可重复N-grams之间找到一个好的折中需要大量的微调。(2)过于遵循概率最大化原则,使得创造性受限。有研究表明,高质量的人类语言并不遵循最大概率法则。换句话说,我们希望生成的文本能让我们感到惊喜,而可预测的文本使人感觉无聊,人类创作的文本所带来的惊喜优于集束搜索生成的文本。
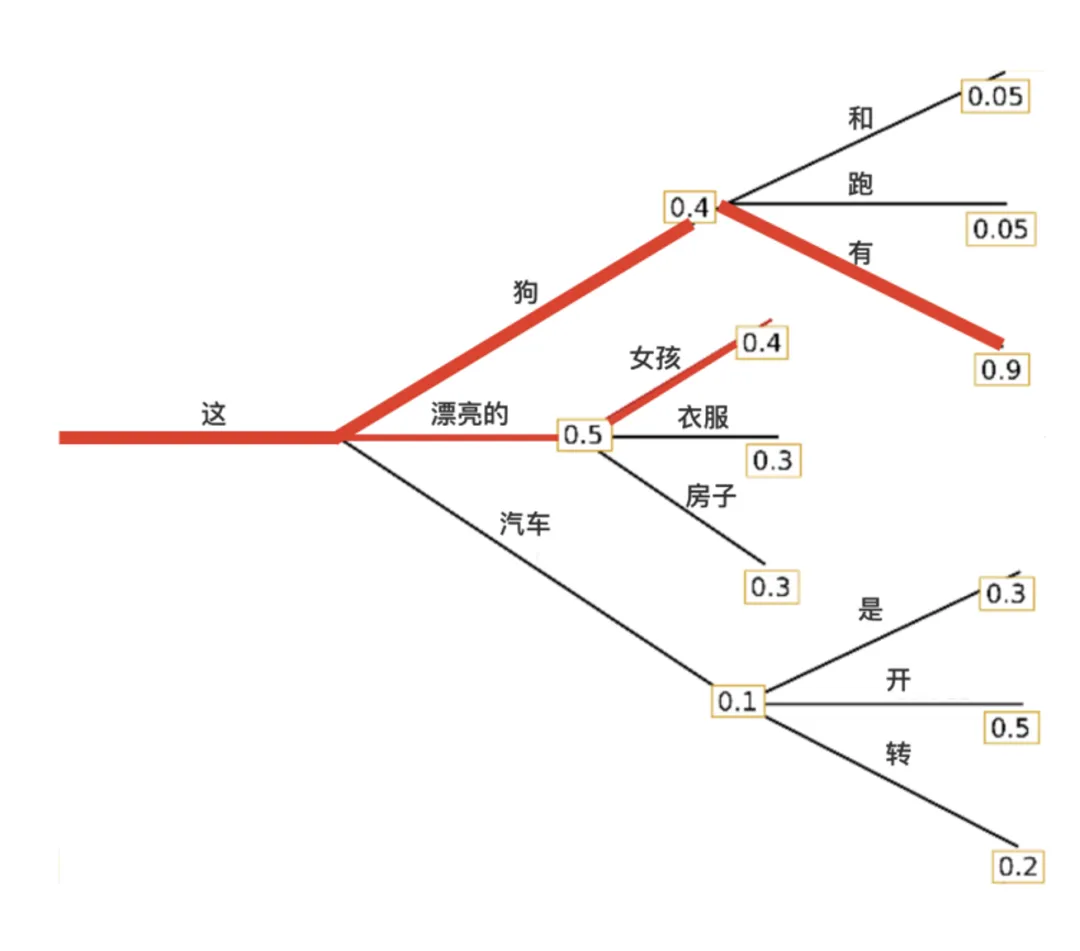 图6.2 集束搜索图示
基于采样的解码方法
基于采样的方法通过引入随机性来增加文本多样性,使生成内容更加自然和富有创造性。
1.随机采样:
随机采样从当前概率分布中随机选择下一个词,而不是总是选择概率最高的词,即在生成时的每一步都从当前概率分布P(w|w1:t−1)中按照概率随机采样一个词。相比基于搜索的解码方法,通过采样生成的文本通常具有更高的多样性,同时也在一定程度上缓解了生成通用和重复文本的问题。图6.3可视化了使用随机采样生成文本的过程。从图中可以看出,使用采样方法时文本生成本身不再是确定性的。单词“车”从条件概率分布P(w|“这”)中采样而得,而“开”则采样自P(w|“这”,“车”)。
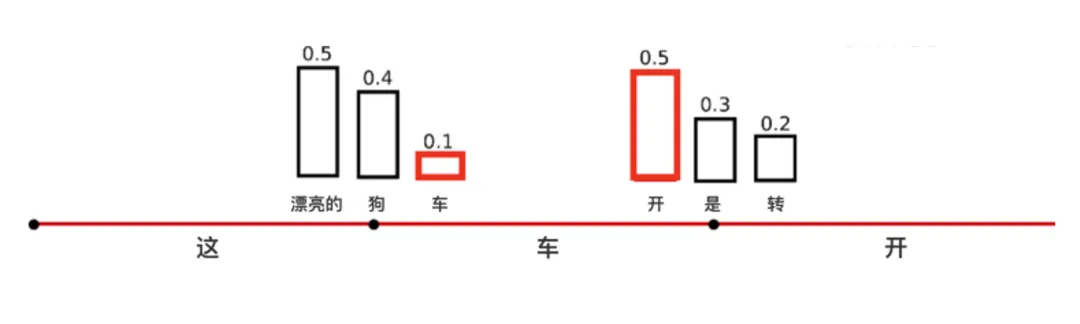 图6.3 随机采样图示
尽管随机采样在一定程度上能避免生成重复的文本,但是对单词序列进行随机采样会带来一个大问题:由于从整个词表中采样可能会采到与上下文无关的词,因此,随机采样得到的文本上下文常常不连贯。这在需要保持逻辑性和一致性的任务中尤其明显。
2.带温度的随机采样:
为了使模型尽可能避免采样到低概率的词,一个有效的方法是设置一个名为“温度”的参数来控制概率分布的弥散程度,通过将logits除以温度来实现温度采样,然后将其输入Softmax并获得采样概率分布。降低“温度”,本质上是增加高概率单词的似然并降低低概率单词的似然。该参数用τ表示,其是一个大于0的实数。生成过程中需要对概率分布的计算方式进行如下修改。
(1)当τ=1时,即为原始的概率分布。
(2)当τ<1时,得到的概率分布将更加尖锐,弥散程度更小,采样的随机性降低;当τ→1时,使用随机采样解码的效果近似于贪婪搜索,这会遇到与贪心解码相同的问题;设置τ∈(0,1)可以避免随机采到概率较小的词。
(3)当τ>1时,得到的概率分布弥散程度更小,采样的随机性升高;当τ→∞时,使用随机采样解码的效果近似于从均匀分布中随机采样。
将温度应用于上面的例子中,结果如图6.4所示,t=1时刻单词的条件分布变得更陡峭,几乎没有机会选择单词“车”了。
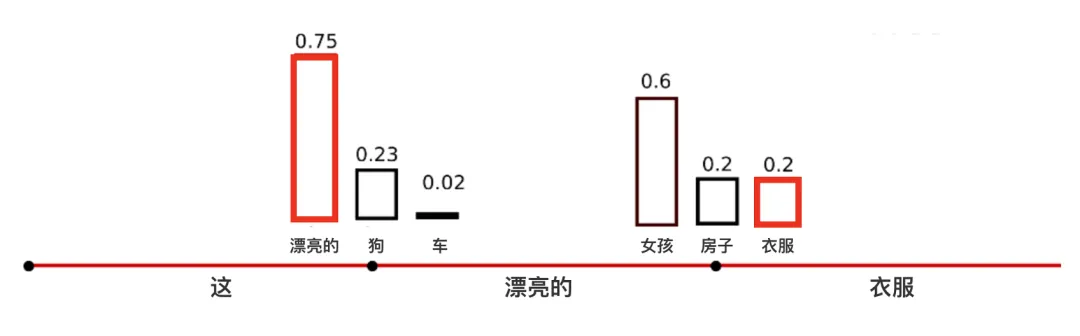 图6.4 带温度的随机采样结果
3.Top-K采样:
在Top-K采样中,概率最大的K个词会被选出,然后这K个词的概率会被重新归一化,最后就在这重新被归一化概率后的K个词中采样。GPT2采用了这种采样方案,这也是它在故事生成这样的任务上取得成功的原因之一。具体来说,在每个时间步,解码器首先选择概率最高的K个词作为候选词,然后根据K个词的相对概率大小从中采样出一个词作为要生成的词。
Top-K采样图示如图6.5所示,我们将候选单词数扩展至10个,以更好地说明Top-K采样。设K=6,即在两个采样步中,将采样池大小限制为6个单词。我们定义6个最有可能的词的集合为VTop-K。在第一步中,VTop-K仅占总概率的2/3,但在第二步,它几乎占了全部的概率。同时,我们可以看到在第二步中,该方法成功地消除了那些奇怪的候选词(“不是”,“这”,“小的”,“用”)。
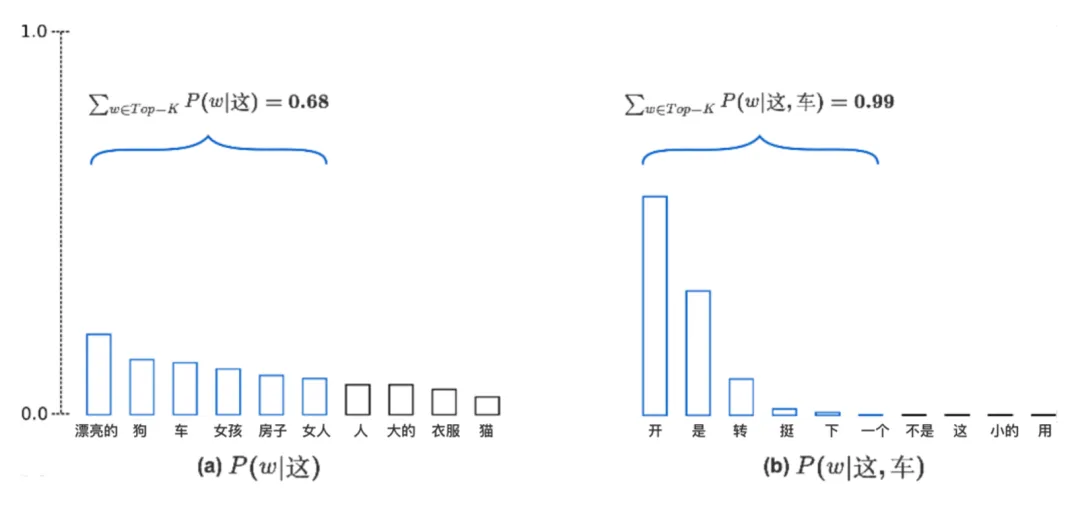 图6.5 Top-K采样图示
4.Top-P采样:
在Top-P中,采样不只是在最有可能的K个单词中进行,而是在累积概率超过概率p的最小单词集中进行。然后在这组词中重新分配概率。这样,词集的大小(又名集合中的词数)可以根据下一个词的概率分布动态增加和减少。Top-P采样图示如图6.6所示,假设p=0.92,Top-P采样对单词概率进行降序排列并累加,然后选择概率和首次超过p=0.92的单词集作为采样池,定义为VTop-P。在t=1时VTop-P有9个词,而在t=2时它只需要选择前3个词就超过了0.92。可以看出,在单词可预测性较低时,Top-P采样保留了更多的候选词,如P(w|“这”),而当单词似乎更容易预测时,只保留了几个候选词,如P(w|“这”,“车”)。
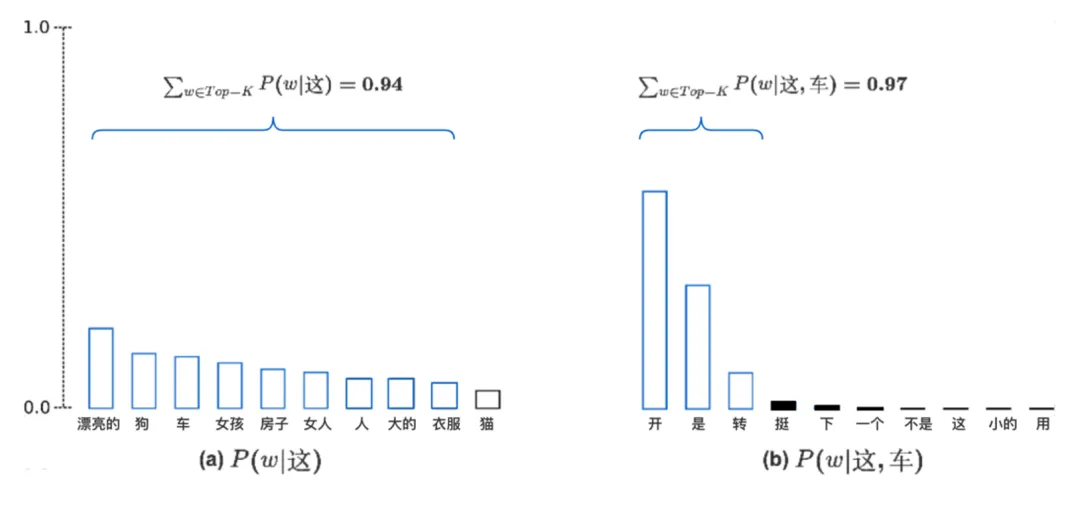 图6.6 Top-P采样图示
从理论上看,Top-P似乎比Top-K更优雅,Top-P通过截断概率分布的不可靠尾部来避免文本生成的退化现象,从包含绝大多数概率质量的token的动态核中采样。而Top-P与Top-K结合使用,这样可以避免概率排名非常低的词,同时允许进行一些动态选择,往往能达到最佳效果。
在开放域语言生成任务中,Top-P 和 Top-K 采样方法通常能够生成比传统贪心搜索和集束搜索更为流畅的文本。后两者常因生成重复文本序列而备受诟病,但近期研究显示,这一问题可能更多源于模型本身(尤其是训练方式),而非解码策略——事实上,Top-K 和 Top-P 采样同样可能出现重复现象。另有研究表明,在基于人类反馈优化训练目标后,集束搜索所生成的文本流畅度甚至能够优于 Top-P 采样。
全文引自《开启智能对话新纪元:大规模语言模型的探索与实践》
 微信公众号
 沪公网安备 31011002000007号