

多模态大规模语言模型(MultimodalLarge-scaleLanguageModel,MLLM)是当前备受关注的新兴研究热点,它利用强大的大规模语言模型作为大脑来执行多模态任务。近年来,大规模语言模型取得了显著的进展,通过扩大数据规模和模型规模,这些LLM
模态与多模态
在介绍之前,我们先了解一下什么是模态,其是指一些表达或感知事物的方式,每一种信息的来源或者形式都可以称为一种模态。例如,人的触觉、听觉、视觉、嗅觉;信息的媒介,如语音、视频、文字等;多种多样的传感器,如雷达、红外、加速度计等。相较于图像、语音、文本等多媒体数据划分形式,“模态”是一个更为细粒度的概念,同一媒介下可存在不同的模态。例如我们可以把两种不同的语言当作两种模态,甚至在两种不同情况下采集到的数据集亦可认为是两种模态。多模态即是从多个模态来表达或感知事物。多模态可分为同质性的模态,例如从两台相机中分别拍摄的图片,以及异质性的模态,例如图片与文本语言的关系。多模态可能有以下三种形式:
(1)描述同一对象的多媒体数据。如互联网环境下描述某一特定对象的视频、图片、语音、文本等信息,即为典型的多模态信息形式。
(2)来自不同传感器的同一类媒体数据。如医学影像学中不同的检查设备所产生的图像数据,包括B超、计算机断层扫描(CT)、核磁共振等;物联网背景下不同传感器所检测到的同一对象数据等。
(3)具有不同的数据结构特点、表示形式的表意符号与信息。如描述同一对象的结构化、非结构化的数据单元;描述同一数学概念的公式、逻辑符号、函数图及解释性文本;描述同一语义的词向量、词袋、知识图谱以及其他语义符号单元等。通常语言模型中主要研究的多模态是人跟人交流时的多模态,包括“3V”:文本(Verbal)、语音(Vocal)、视觉(Visual)。多模态语言模型不仅支持文本输入输出,还支持图片、音频和视频输入输出。
典型多模态模型
多模态语言模型MultiModal-GPT和Otter
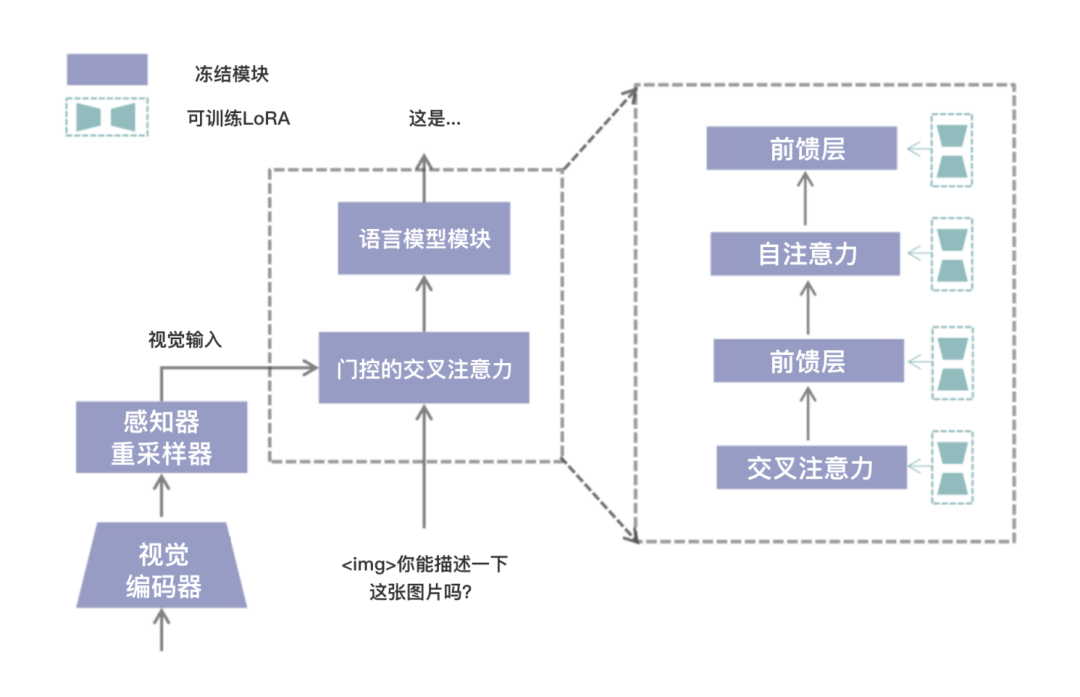
图9.1 MultiModal-GPT模型的整体框架
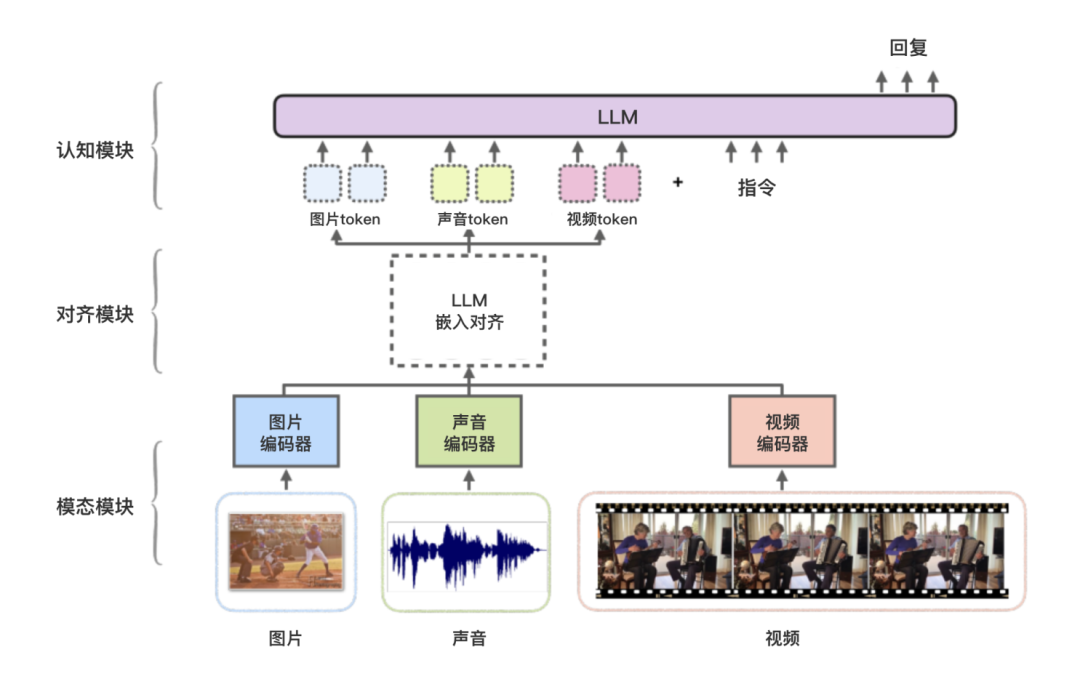
Video-llama、Macaw-LLM、X-LLM支持将图片、视频、声音和文本作为输入。Macaw-LLM模型的整体框架如图9.2所示,主要包含模态模块、对齐模块和认知模块这三个模块,Macaw-LLM实现了各种输入模态的统一,其可以将图片、声音、视频和文本作为输入,最后通过语言模型解码成文本输出。
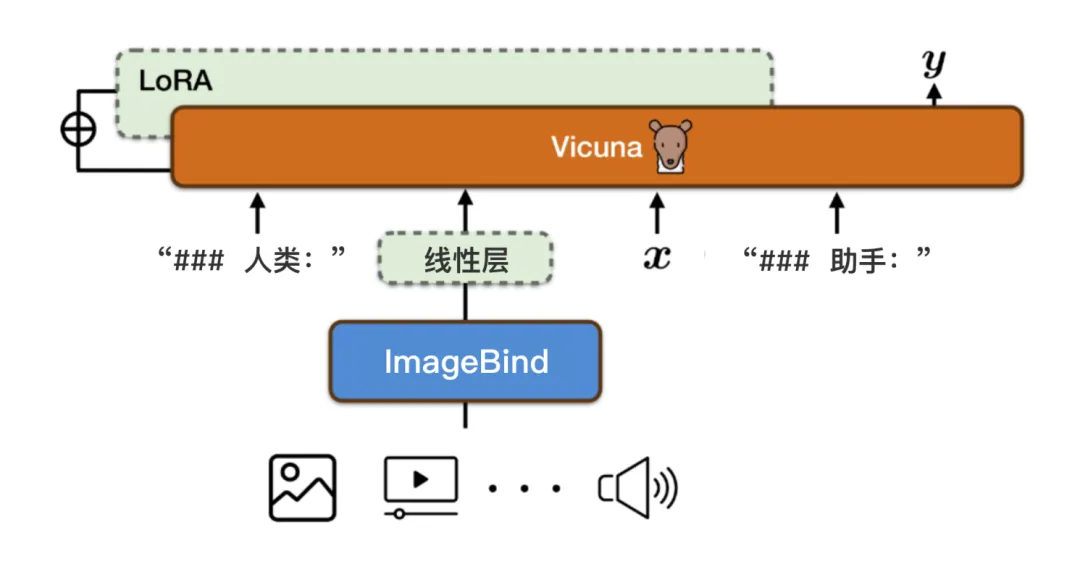
PandaGPT
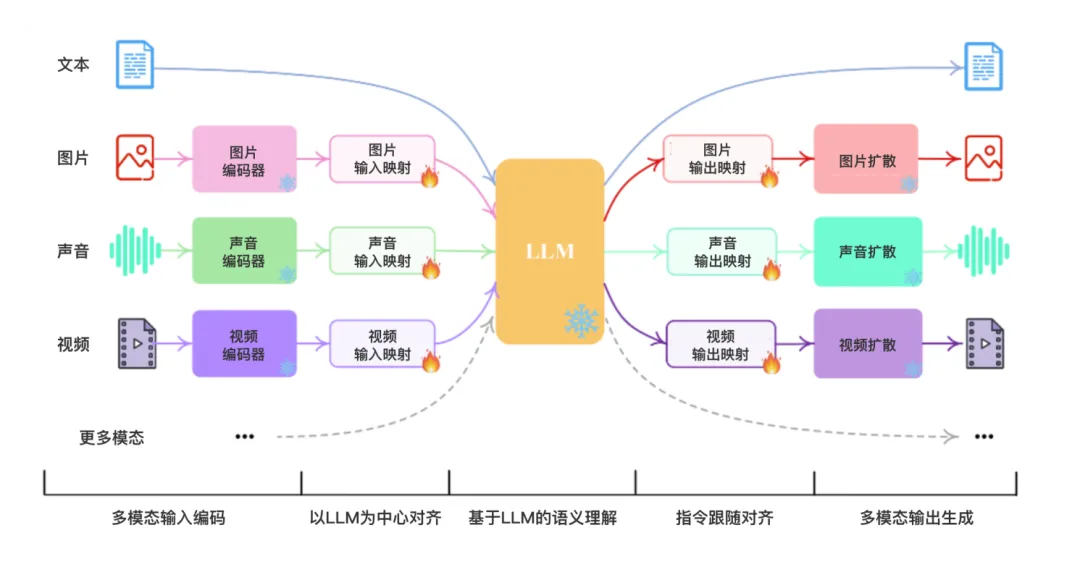
其实这些模型的结构都大同小异,都是以现有的大规模语言模型为核心,在多模态输入和多模态输出侧分别加上一个编码器和一个解码器或扩散模型(DiffusionModel)生成模型。编码器就是把图片、音频和视频编码成大规模语言模型所能理解的向量,根据大规模语言模型的输出解码器生成文本,或扩散模型生成图片、音频和视频。
MLLM多模态模型的优势
目前,大型视觉基础模型在感知方面取得了快速进展,传统的视觉和文本的结合更加注重模态对齐和任务统一,在推理方面发展缓慢。鉴于这种互补性,单模态LLM和视觉模型逐渐融合,最先形成了多模态大规模语言模型的新领域。从发展人工通用智能的角度来看,MLLM可能比单模态的LLM更有优势,原因如下:
(1)MLLM更符合人类感知世界的方式。人类自然地接收互补和协作的多感官输入。因此,多模态信息有望使MLLM更加智能化。
(2)MLLM提供了更用户友好的界面。由于多模态输入的支持,用户可以更灵活的方式与智能助手交互和沟通。
(3)MLLM是更全面的任务解决者。MLLM通常可以支持更多、更广泛和更复杂的任务。
GPT-4展示了令人惊叹的能力,掀起了对MLLM的研究狂潮,研究界也做了许多努力来开发功能强大且开源的MLLM,并展示了一些令人惊讶的实际能力,如基于图像编写网站代码,理解模型的深层含义和无须OCR的数学推理,这些能力在传统方法中很少见,这表明了通往人工通用智能的潜在路径。
全文引自《开启智能对话新纪元:大规模语言模型的探索与实践》
 微信公众号
 沪公网安备 31011002000007号