

导读
人工智能目前在经典人工智能范围内主要技术有哪些?据陈小平教授分析,现有AI技术主要分为两大类,且它们面临的共同挑战是封闭性问题。如果我们仍想在经典人工智能,乃至整个人工智能问题上获得进步,我们需要攻克封闭性这个难关。其中一条设想是,在未来15年内,虽然存在着封闭性的限制,我们在应用中仍然可以实现大规模的产业落地。这是一个好消息。封闭化和开放知识便是两种可以考虑的方法。
经典人工智能的科学内涵
经典人工智能是图灵1950年提出来的,他用的词是thinking machines(思维机器)那思维机器研究什么呢,不同的观点有不同的看法:自然科学观点是机器思维的规律,哲学观点是研究机器思维的本质。经典人工智能观点用图灵的话来说就是机器能模仿人类思维的哪些功能。图灵说的机器指什么?图灵明确说只考虑图灵机。他不是理论上排除其他任何机器,而是因为当时只有图灵机。那么经过了70多年,我们现在在软件层次上做的人工智能还是在图灵机上做的,即电子数字计算机。所以这70年就没有跳出图灵的手掌心。那什么是模仿呢?他也说得很清楚,机器思维不是要跟人的思维一样,而是像人的思维就行了。
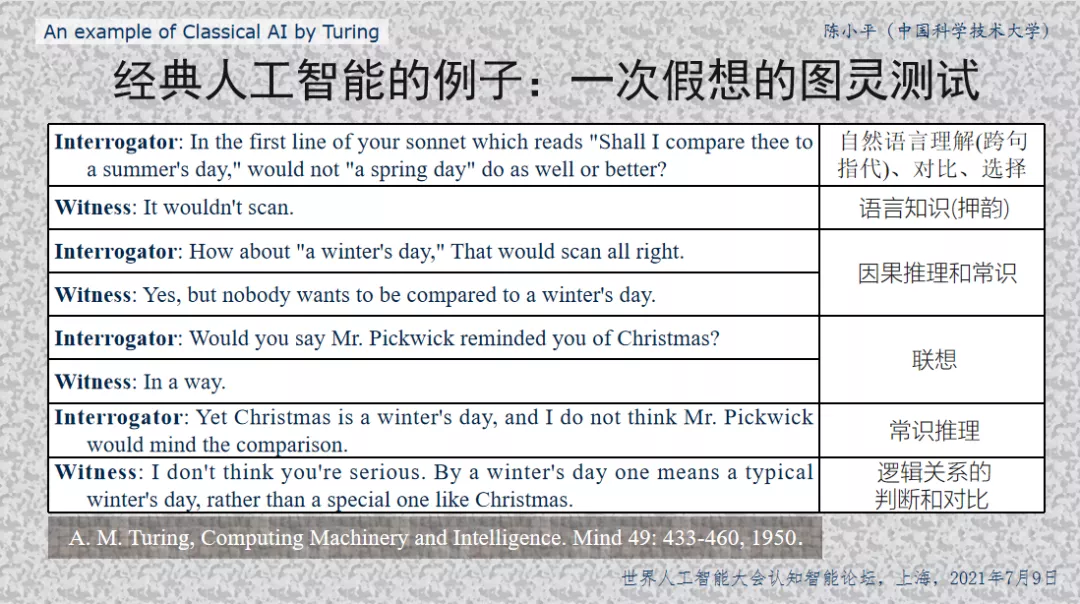
他在1950年的论文里提出了一个假想的图灵测试。陈小平教授概括了一下内涵:思维机器的图灵假说——推理、决策、学习、理解、创造,这些都可以用计算机模仿。(图灵没有提出上述假说,他认为用自然语言不能定义机器思维。所以他提出了“模仿游戏”(图灵测试)作为实验验证手段)。
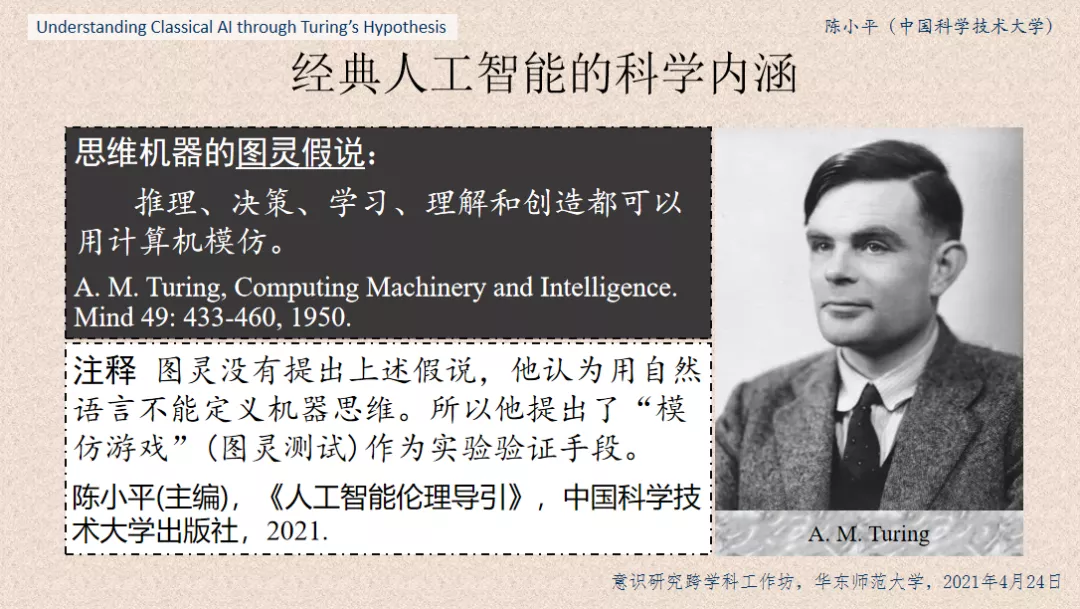
人工智能是要让机器干活,所以这样看来其实图灵不仅开创了科学的一个新的领域、新的分支,而且创立了人类思想的一种新的类型和科学。
现有AI技术和封闭性挑战
经典人工智能的局限和挑战都在和现实世界有关的地方。这个挑战有哪些呢?回顾经典人工智能主要的类型,陈小平教授总结了以下两种,一种叫训练法,包括深度学习,还有一种叫强力法,在整个人工智能研究里大概70%的工作是属于这两类的。继通用问题求解、专家系统、深度学习技术体系三次浪潮之后,AlphaGoZero获胜已经代表着人工智能进入第4次浪潮了。
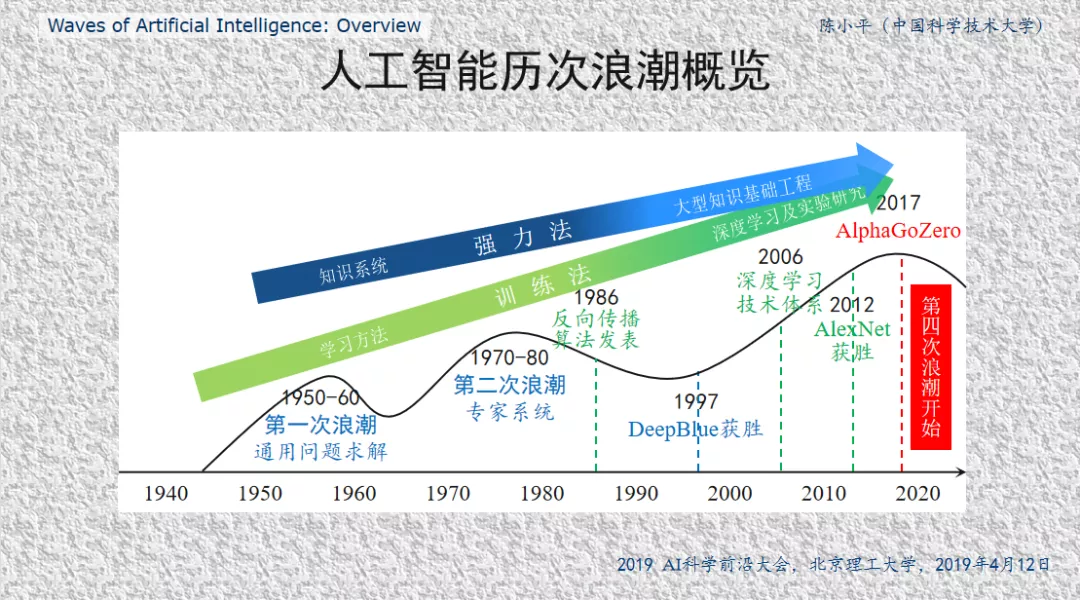
强力法它又分成三种即推理法、搜索法、规划法。马尔科夫决策是有数学基础的,是可解释的,这便是强力法与深度学习和训练法不一样的地方。
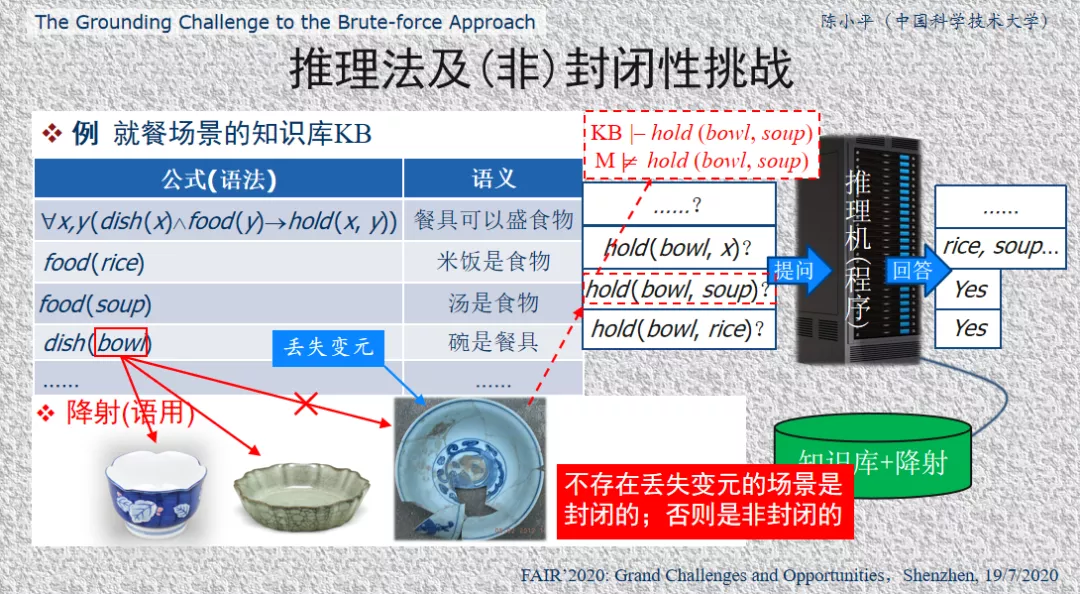
强力法里面陈小平教授介绍了推理法,并通过一个案例进行了解释。比如说“就餐”的问题,机器人它也不吃饭,它就没有就餐的知识。我们写一个知识库,比如第一条是关于餐具、食物,米饭是食物,汤是食物,碗是餐具等等。把这个知识写好以后呢机器人对推理机提问,根据这个推理机的回答呢,它再做决策。那可以问什么问题呢?比如说“碗能不能盛米饭”?机器人不知道碗能盛米饭,它不知道,所以它就问推理机。那推理机回答了“YES”。那注意,这个问题“碗能还是不能盛米饭”,在你的知识库里根本就没有。这个知识库也是这样,就写最基本的,我们大部分都是推出来的。那还有“碗能不能盛汤?”这也是推出来的。这样看如果只在我们现在考虑的范围内,这个推理法能做得非常好。但是麻烦是如果机器人涉及现实世界、涉及到行动,这个就有问题了。比如说这个符号“bowl(碗)”我们写在知识库里,它根本就不知道是啥意思。人理解它是“碗”,对机器人来说,它要知道这个对应的是“碗”,它要知道现实世界里什么东西是“碗”。那这时候呢,我们就需要涉及应用了,就是涉及到这个“降射”,现实世界的碗要和这个符号(“bowl”)对应起来。一般都认为这个很简单,但是有难的。你说这个像一个盘子是不是碗呢?专家考证,宋代汝窑碗也是碗。这个问题都不大麻烦,大概90%以上的都好处理,就不到10%麻烦就来了。破碗,破碗是不是碗?那机器人认为破碗是碗。那么这样一个对应,那就坏了。机器人就有可能拿破碗去盛汤,因为你原来知识库推出来的碗可以盛汤啊,破碗也是碗,破碗也能盛汤。结果呢,知识库推出来的破碗的盛汤,实际上它有问题是吧:这个汤洒到地上,把老人摔倒了,那可能有生命危险,这后果非常严重。那怎么办呢?这个对应可能是不能对应,不对应的话这就变成了丢失变元。实际上一般人想不到还有“破碗”,大量这样的东西人们就想不到,这是大量的丢失变元,所以就提出封闭性的概念。如果不存在丢失变元,这样的我们现在能解决。但是如果有丢失变元,现在没办法,这个至少经典人工智能没办法,别的也没看到有办法。
应对封闭性有两条思路,一类满足封闭性假设。这是从产业的角度来说,还有一个超越封闭性假设。
现有AI技术应用途径:封闭化
怎样满足封闭化,陈小平教授总结封闭有6个条件,就是对强力法和训练法有6个条件,有人提出质疑举了一个反例说AlphaGo,人家AlphaGo不用封闭化,就做得非常好,陈小平教授研究AlphaGo以后才发现AlphaGo是封闭性最好的1个例子,这6个条件它都符合。
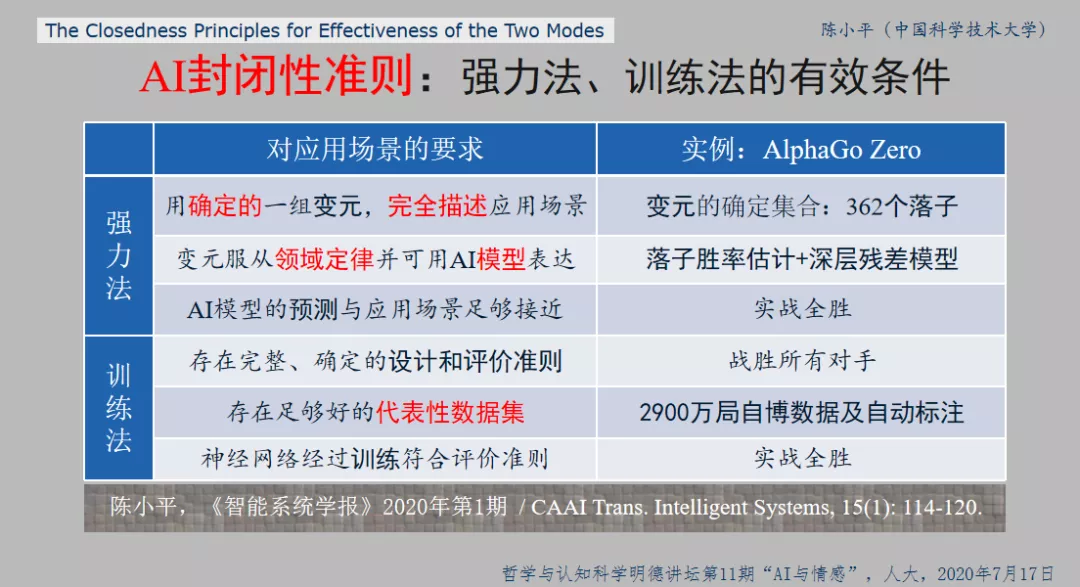
大家都知道AlphaGo有4项核心技术,前面2项是强力法,后面2项训练法,不要认为AlphaGo就是深度学习,深度学习只是1/4,它主要的理论的贡献,理论的创新是在简化的决策论模型。简化决策论是要用T函数(对手在棋局s下选择落子a达到棋局s’的概率),那么用了T函数这是和对手有关,这个就没法弄了,这个就不封闭,这个数据就不能自动采集。AlphaGo Zero是用平均胜率估计取代了T函数,那么这样就和对手无关问题封闭化,那么就自动采集数据了,成功秘诀是在这里。那么用这样的办法,我们产业上可以用到哪些地方?陈小平教授过去5年调研了大量的产业,发现智能制造、智慧农业、物流业,IT基本上是封闭的,还有一部分服务业都能够通过封闭化的手段,让人工智能技术得到大规模的产业化落地。
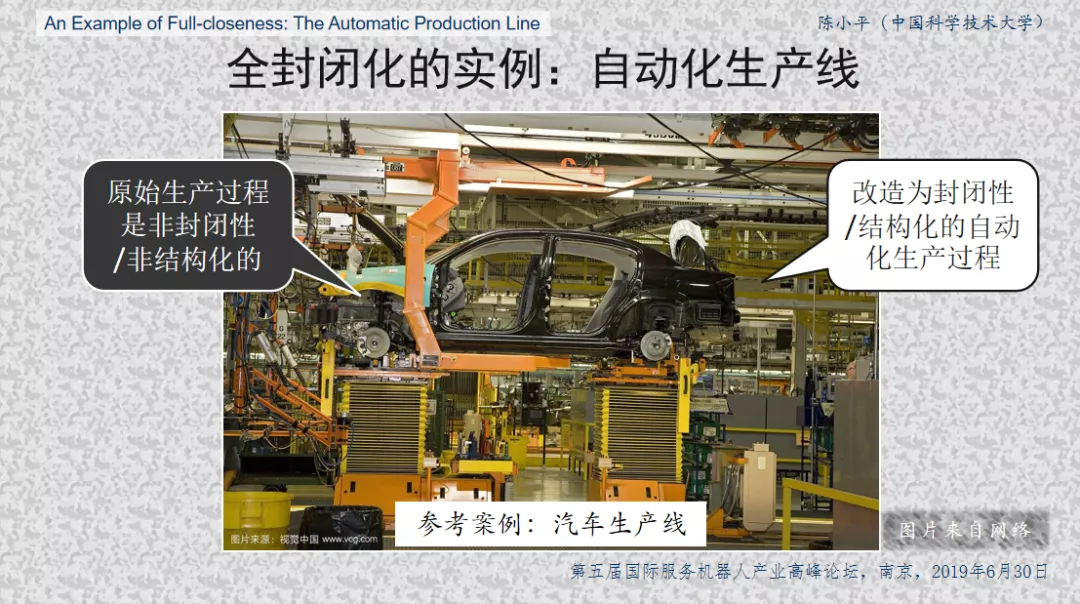
具体的封闭化又有不同的类型,一种是全封闭化,一种是半封闭化,那么还有柔性化等。全封闭化看的比较多,就是过去的工业生产叫结构化,实际上它就是一个全封闭化,就是全封闭化。
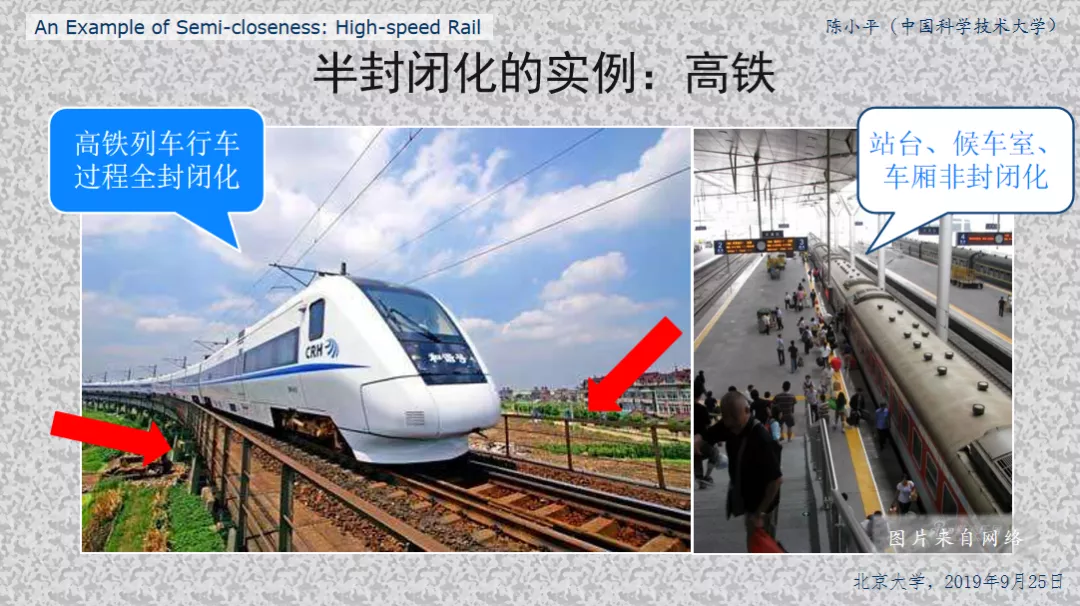
现在的半封闭化对于人工智能机器人来说可能是有效的,范围更宽的,但是现在确实产业上没有看到大规模应用的例子,有小的例子,比如高铁就是一个半封闭化,就是高铁的行车这一部分是会造成伤亡的。他就把两边就封起来他就不会造成伤亡了,这部分就封闭化了,剩下的站台候车室车厢都没有封闭化,那么有一定的要求,乘客要符合他的要求,结果整个他是个半封闭化的,他运行得非常好,这个例子我们可以用来指导我们在产业上用于人工智能技术的半封闭化。
超越封闭性:开放知识途径
如何超越封闭性?一种方法是开放知识途径。问题的麻烦在于我们建模的时候,通常我们只能想到一些典型的场景,这个也是合理的,思维经济的原则我们总要遵守。就导致大量的变异的场景没有想到。结果运行的过程中,它出现了有些变异场景,有些出现新的变元,模型就无效了。
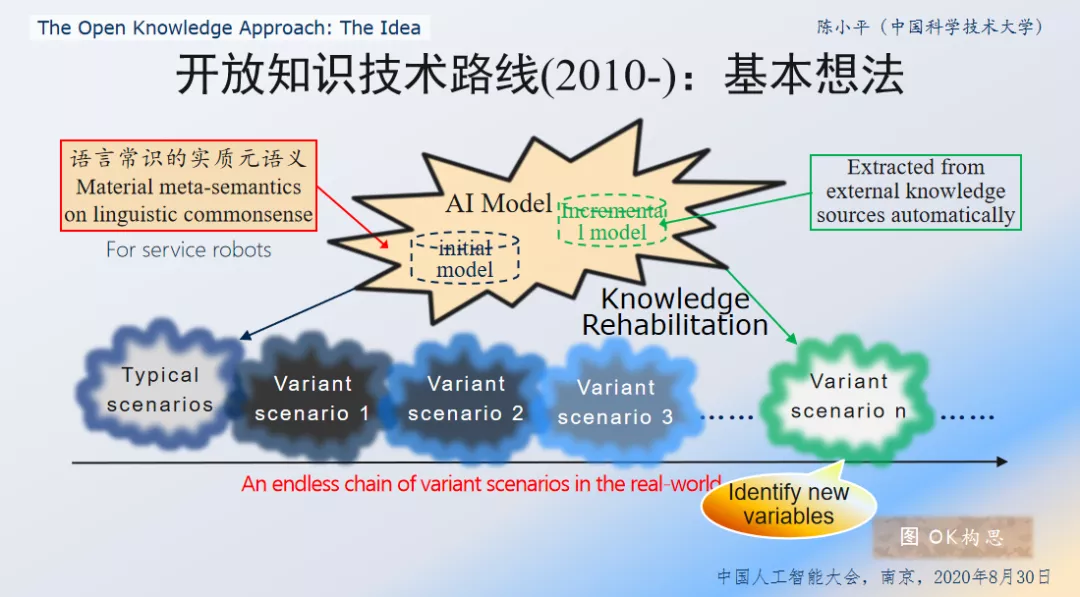
所以需要有一个一般的观察,就是在非封闭的情况下,通常AI模型总会丢掉一些知识。针对这种情况我们的解决办法是这样,先建一个初始模型,只考虑典型的场景,然后在机器人运行的过程中,让它具备一定的能力去发现是不是出现新的变元,一般的情况我们现在做不到,但是某些情况下我们是可以做到的,陈小平教授实验室已经能够做到了。那么这个时候再建一个增量模型,这个是自动建,从外部找知识自动建。那么这是第二个挑战。第三个挑战就是这两个模型要合起来才能解决问题,这个是最难的,也是最花时间的,现在想的办法是用一个基于语言常识的一种元语义,然后把它们组合起来,但是这个只用于服务机器人领域,别的领域可能有别的办法。
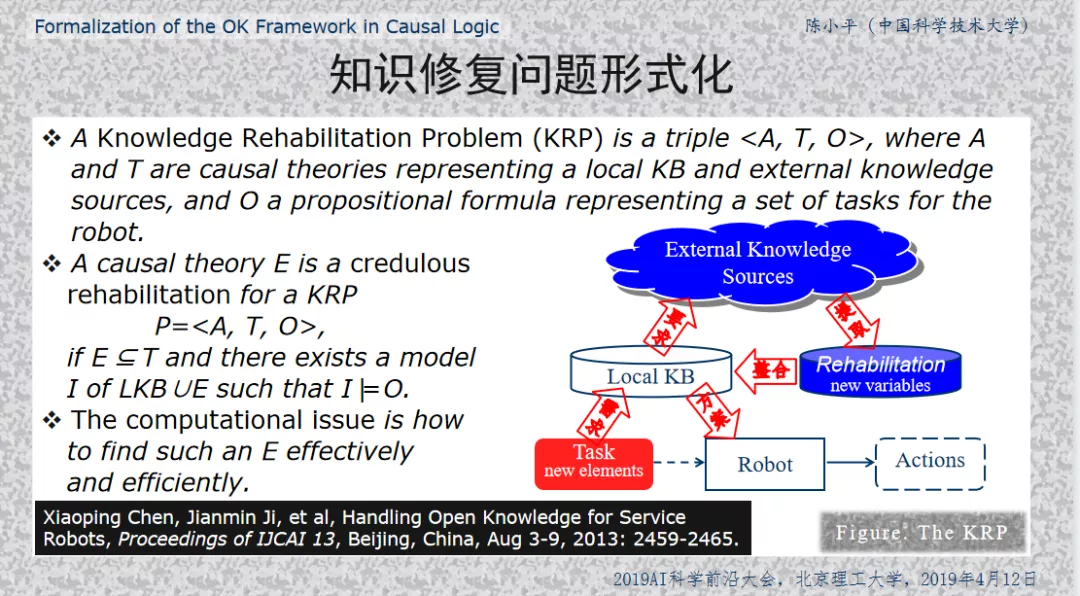
陈小平教授也做了一些理论的研究,整个问题叫做一个知识修复的问题,知识修复问题我们把它形式化后大概是这么一个问题,就是机器人接到任务以后,它先用它的本地知识库尝试解决这个问题,解决不了,再把这个任务的需求提出来,然后到外部知识源去找这个知识,找到一部分知识,如果有用的话,这个是一个知识修复,那么和本地知识库整合,然后机器人做自动规划,用自动规划出来以后项目就执行规划,这个问题就解决了。
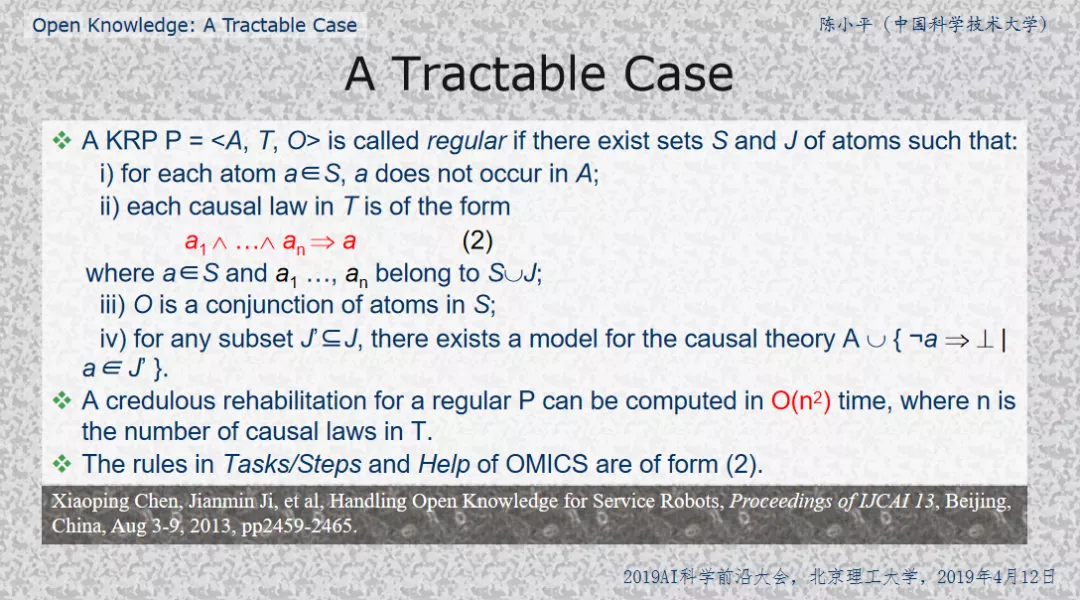
整个框架都是这样,但是计算复杂度非常高,做了分析,计算复杂度基本上都不是实际可行的,都不是 Tractable,但是当外部知识源的知识是由公式(2)这种形式(参照上图)的时候,那么就有一个n平方的算法,这个n是代表外部知识源的规模,这个就可以做了,所以陈教授后面的实验都是针对这一类的外部知识源,但是现在有大量的网上的在线的知识是具有这种形式的,所以 open knowledge路径它是具有普遍性的可行条件的。
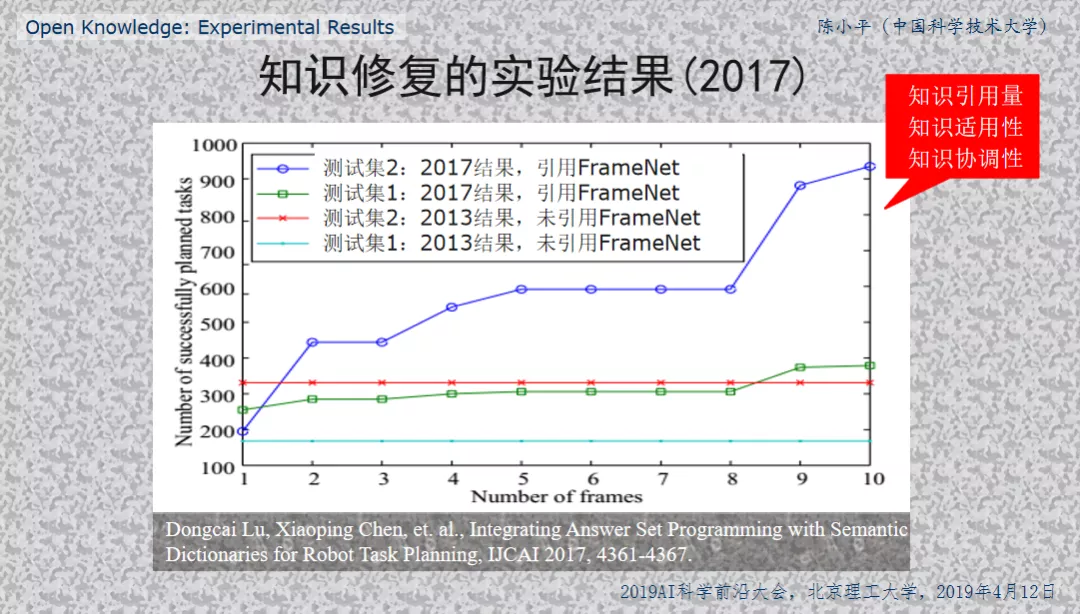
陈小平教授团队做了大量的实验,这个是2007年的一个实验,有两个测试集,一个测试集比较大,增加的知识比较少,这个效果不明显。第二个测试集任务比较少比较难,增加知识比较多,性能提升的非常快。最后总结就是三个因素:知识引用量、知识适用性、知识协调性。如果处理得好,open knowledge的途径就能够显著的提高机器人的问题求解能力。它最初是很小的模型,它不断的从网上抓取知识,它的能力不断的提升。
本篇内容在陈小平教授的下面几篇参考文献里有更详细的阐述,大家有兴趣可以进行参考。
陈小平,人工智能中的封闭性和强封闭性——现有成果的能力边界、应用条件和伦理风险,《智能系统学报》2020年第1期:114-120。
陈小平(主编),《人工智能伦理导引》,中国科学技术大学出版社,2021年3月:1-60页。
陈小平,图灵假说70年:两类AI与封闭性挑战,2020中国人工智能大会,南京,2020年8月30日。
 微信公众号
 沪公网安备 31011002000007号