

导读:
科学可以很好地解释有生和无生命世界,但是科学能否解释感质(Qualia)?比如,红酒的口感、晚霞的红色、头疼的痛感和初恋的痴迷?很多人认为我们需要一种新的科学去理解感质……而我们并不这么认为。我们认为科学可以解释感觉是如何产生的,像愉悦和疼痛,无论是在血肉动物,还是硅和金属构成的机器人身上。
以下内容为图灵奖获得者Manuel Blum教授及其夫人Lenore Blum教授演讲内容节选
何为意识
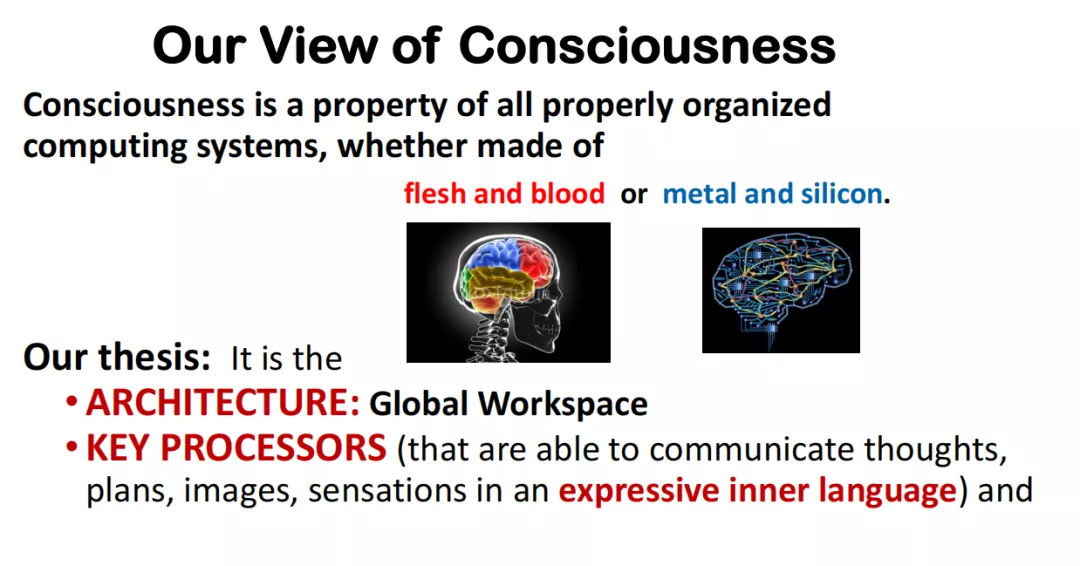
在Blum夫妇的观点中,意识是任何经合理组织的计算系统所拥有的一种性质,无论这种系统由血肉组成还是由金属和硅组成。它包括架构(全局工作空间架构),还有一些关键的处理器,它们能用一种丰富的内在语言相互沟通想法、计划、图像、感知。特别要指出,内在语言处理器和世界模型处理器通过一种被称为大脑语言的表达能力丰富的多模态内在语言互相交流,并且存在一个由预测、反馈和学习组成的循环动力学机制,使得它们具有意识,还有一些动机、欲望、能量和最基础的认知能力。
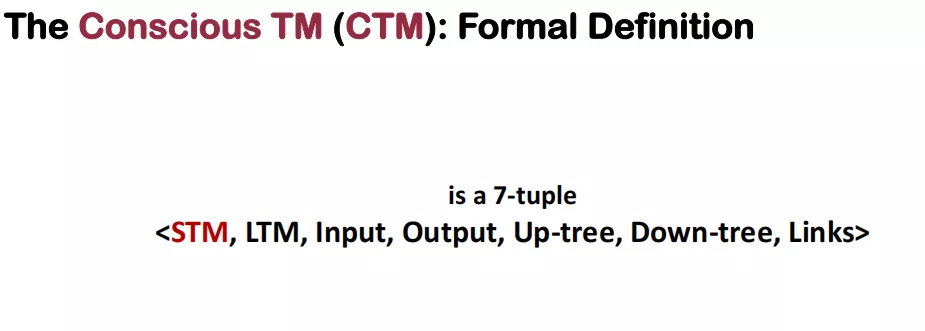
意识图灵机(CTM)
Blum夫妇对于意识图灵机的正式定义。它被定义为一个七元组,因为图灵机也是定义为七元组。其中包括短时记忆STM,长时记忆LTM,输入,输出,上行树up-tree,下行树down-tree和连接。
STM是我们的短时记忆,读写记忆。这是我们的舞台,并且我们的舞台可以持有一个信息块。我们追求的是简洁性,一个信息块就够了。
我们许多许多长时记忆处理器。它们是我们的无意识处理器。它们互相并行,并且性能强大。这是个巨大的集合,据我们推测也许有10^7个,它们最初并没有多少关联,但随着CTM的逐渐成熟,它们的连接会越来越紧密,我们接下来会看到。它们就是我们的观众。
我们同样有来自外界的输入映射。这些映射从外在世界通过如眼睛、耳朵等感官进入一些特殊处理器。还有语言,外部世界语言会被翻译为内部的大脑语言。大脑语言是意识图灵机的处理器用来相互交流的内部语言。这是一种用来表达内在语言,内在视觉和内在感知的多模态语言,通过称为主旨的单词和短语来表达。这种语言比外部语言更加丰富且更具有表现力。拥有一种表达能力丰富的内在语言是感受到意识的重要组成部分。
现在我们也有了长时记忆处理器发送给能影响外部世界的行动器的输出映射。同时我们还拥有了从大脑语言到世界语言的翻译方法。
输入映射和输出映射都会进入和离开长时记忆处理器,但是它们不会通过短时记忆。再次强调,这只是一个简化模型。Baars的模型中是需要通过短时记忆的。事实上,大体上我们仅仅将短时记忆看作CTM的有意识内容的容器。
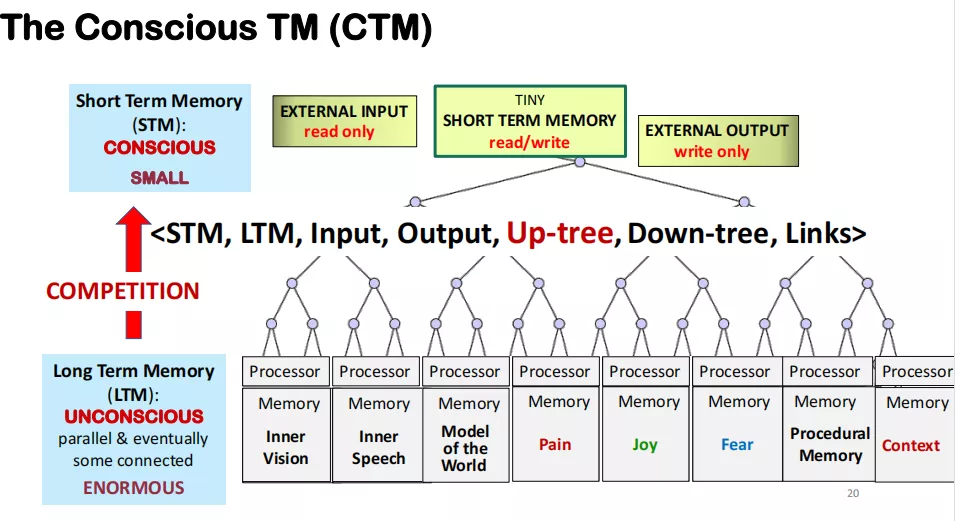
我们有上行树作为长时记忆之间互相竞争并将信息放上舞台的通道。我们认为信息以信息块的形式组成,一个信息块是一个六元组。信息块包含了地址,来源处理器的地址。如果有10^ 7个处理器,则地址为一个七位数字。然后是信息块加入竞争的时间点。主旨(gist),非常简要的一条信息,可以是一个询问、询问的答案、一个想法、一个宣告等处理器想要放入短时记忆的信息。然后是权重。权重是处理器给主旨分配的值,可以是正值也可以是负值。然后我们有强度,起始时为情绪值权重的绝对值。当信息块沿着竞争树上行时,地址,时间点,主旨和权重会保持不变,而强度和情绪值会发生改变。
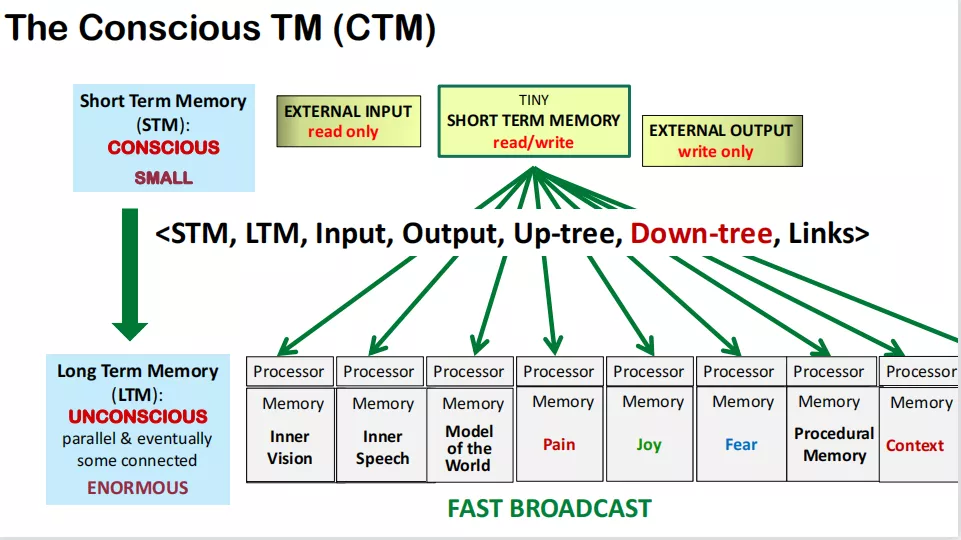
紧随着一个信息块进入短时记忆,它会立刻通过下行树被广播到所有长时记忆处理器中。即每个处理器都集中注意力在进入短时记忆的信息上。
事实上,有些处理器可能过于莽撞,它们给自己的想法过多的权重,导致它们进入了短时记忆,不过晚些时候它们发现自己的想法错了。或者相反的,有些情况下一些处理器比较谨慎但是非常聪明,它们提供了优质的信息,却没能进入短时记忆,所以它们就需要提高权重。所以我们在每个长时记忆处理器中采用的是Avrim Blum的沉睡专家算法,该算法倾向于获取不同处理器间的平衡。
有一个漂亮的推论:信息块进入短时记忆的可能性与由f概率值计算出的重要性成正比,因此与提交它们的处理器的地址无关。
下面是展现这个推论的例子。将把f定为强度,因为它是一个加性的竞争函数。这里有四个处理器。
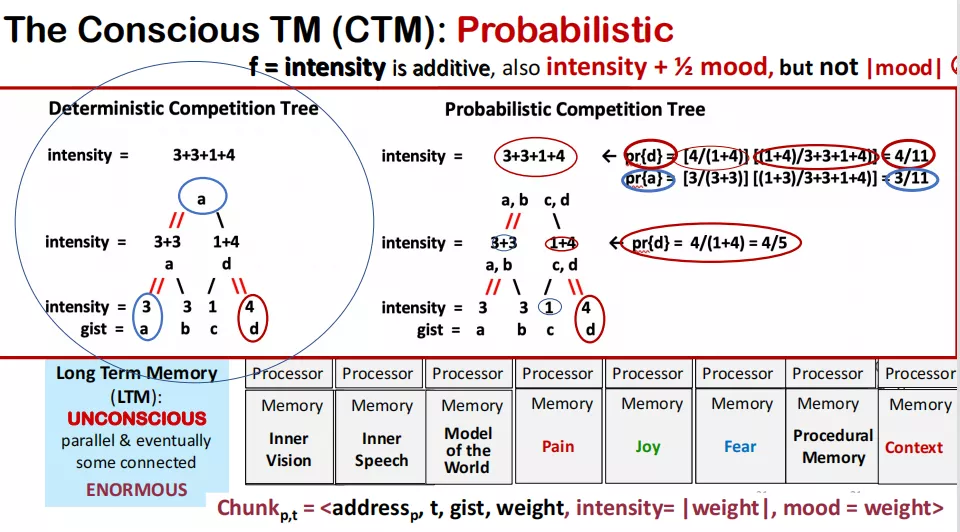
图片左侧是一个确定性的竞争函数,图片右侧是一个概率性的竞争函数。它们都有同样的四个处理器各自投入相似的主旨,a b c d, a b c d,强度分别为3 3 1 4, 3 3 1 4。
如果你看这棵确定性的竞争树,d有着最高的强度值4,不过由于我们安排底层处理器的方式,最终登顶的反而是a。
另一边呢,在这棵概率性的竞争树里,d登顶短时记忆的概率是4/11, 而a登顶的概率是3/11。
甚至c也会有机会登顶,概率为1/11。换句话说,即便有着极低的强度值,仍然有概率能进入短时记忆,一个可喜的特性。
好的,现在让我们完整走一遍该系统。我们有一个输入映射,外部世界传来了一些信息,然后我们的内部视觉和恐惧处理器对信息产生了反应。
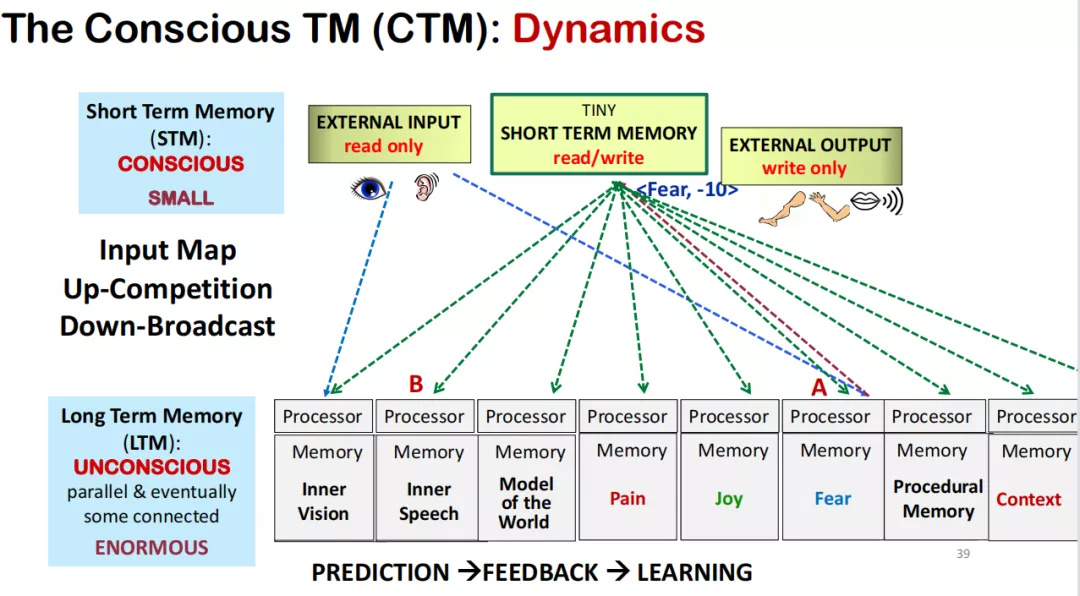
也许恐惧处理器的信息块赢得了竞争,进入了短时记忆并且立刻被广播给了所有长时记忆处理器。一些处理器产生了反应,尤其是语言处理器,对恐惧作出了反应。请注意,当B回答了A的请求时,处理器A会和处理器B连接起来。所以在这个阶段,内部语言回应了恐惧,两者之间会产生一种连接。这正是赫布理论提出的:一起激发的神经元连在一起。更重要的是,对我们来说连接的生成使得有意识的处理变为无意识。
所以一段时间之后,CTM从任务中得到成长,会有越来越多的连接生成,长时记忆处理器之间也会有越来越多的活动。如同Poincaré的例子里一样,长时记忆处理器在无意识中热火朝天地工作。
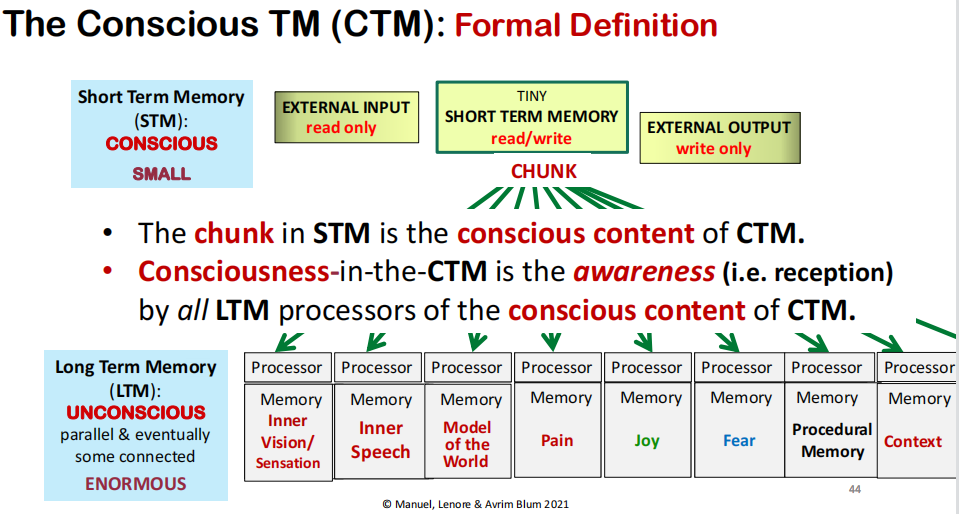
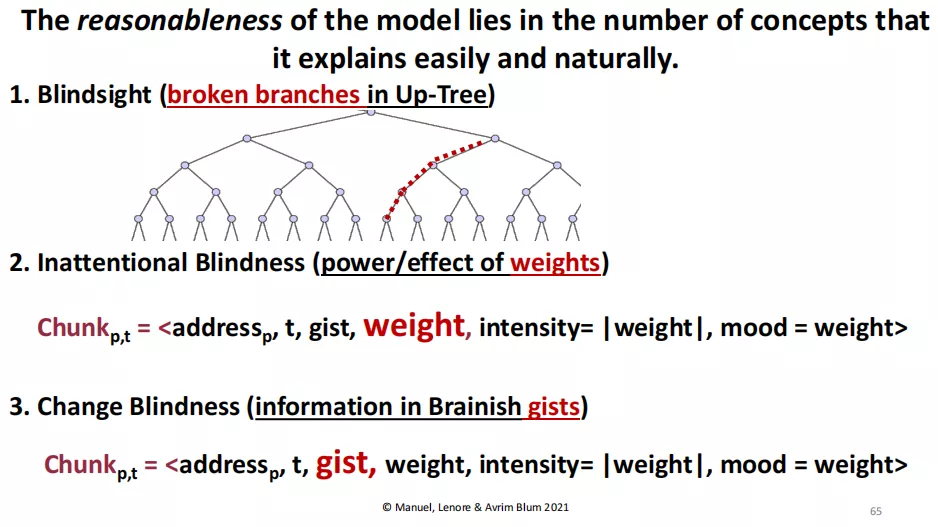
Blum夫妇认为进入短时记忆的信息块即为意识图灵机的有意识内容。CTM的意识即为觉察,换言之即所有长时记忆处理器对CTM有意识内容的接收。信息块不断地竞争进入短时记忆和广播创造了我们所称的意识流。对意识的定义的合理性由这个模型能轻易而自然地解释的概念的数量佐证。
三个跟视觉有些相关的概念
第一个是盲视例子
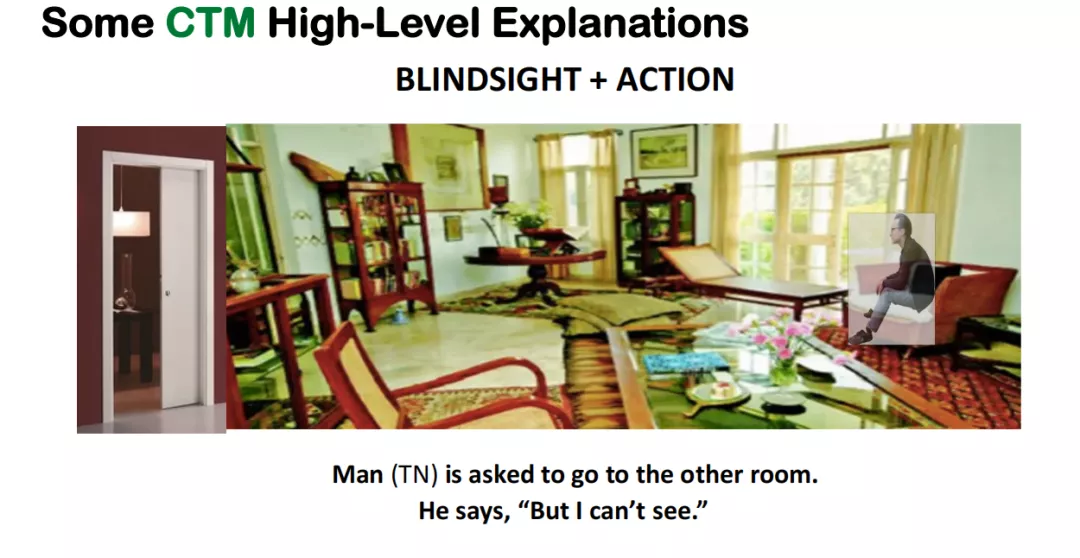
在这间非常复杂混乱的房间里的沙发上坐着一个人,并且他被请求走去另一个房间,难度不低于越野跑。或许他们要到另一个房间吃饭。这个人说,我看不见呀!尽管如此,他仍然站起来,走去了另一个房间,正确穿过门也躲开了所有的障碍物。究竟发生了什么?从宏观层面说,这里有一种解释,外部世界的输入确实进入了视觉处理器。视觉处理器正常工作并且发送信息给了行走行动器。然后上行树,从视觉到短时记忆的连接损坏了,或者不存在。这就是发生的情况。这个盲视患者对于他能够看见东西这一事实的没有意识。没有信息被上传到短时记忆以供广播。我们有理由相信这种情况在大脑中会发生。当视觉处理器无法使用短时记忆时,这个人将不会意识到他拥有视觉。
第二个是非注意盲视的例子
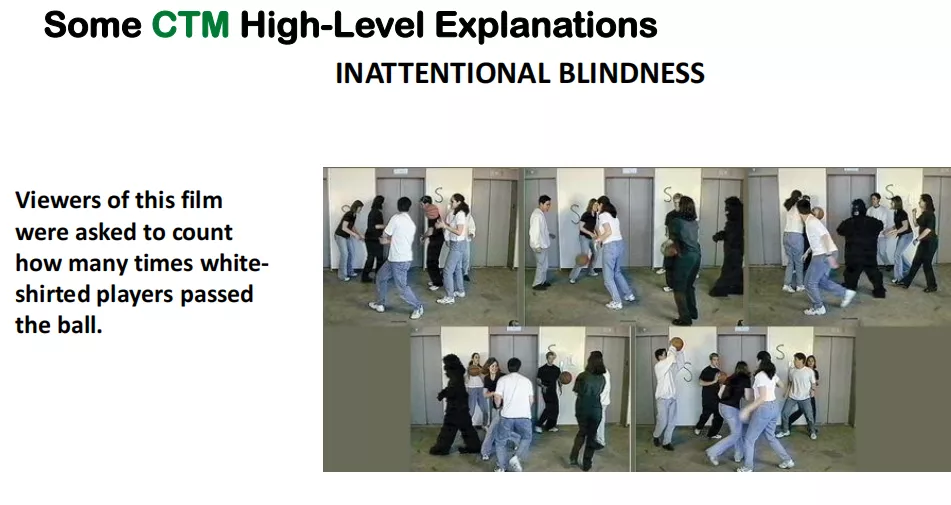
这里有一个相当著名的视频,你也许已经看过。视频的观看者被要求去数穿白衣的球员总共传了几次球。大家的表现相当不错,大多数人的答案是15次,我猜是正确数字,不过他们看见图里的大猩猩了吗?你看见大猩猩了吗?大猩猩很直接的肉眼可见。所以发生了什么?为什么我们没看见大猩猩?当我们在执行像数白衣球员传球次数时这种任务时,我们在竞争中给了相关信息块更高的权重。所以当我们在完成任务时,我们很可能不会意识到图片中有着较低权重的部分。我们没有关注任何黑色的物体。所以正是信息块中主旨的权重导致了这种非注意盲视。
第三个是变化盲视例子
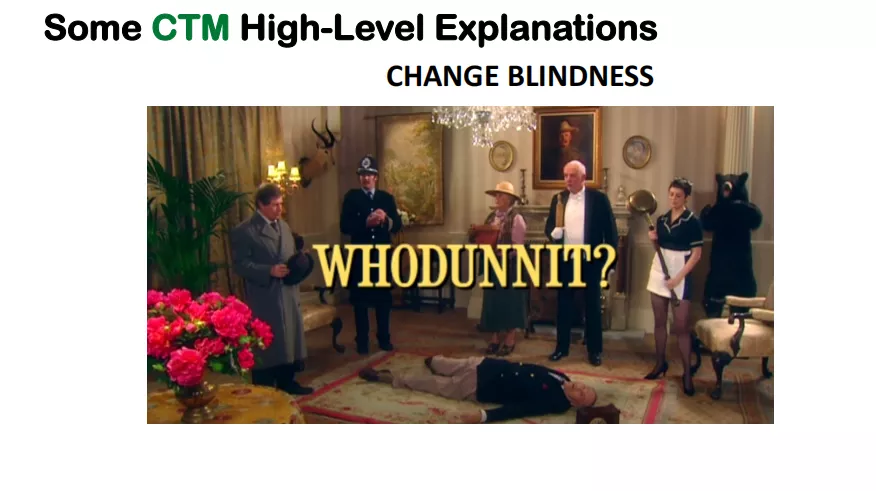
一名侦探走进了房间,他说:“很明显就是这间屋里的人谋杀了Lord Smythe,现在每个人告诉我你们的行踪。”女仆说:“我正在主卧室里给铜器抛光。”管家说:“我正在给老爷的松饼上黄油。”Smythe夫人说:“我正在花房里种我的牵牛花。” 当然侦探立刻说道:“治安官,逮捕Smythe夫人!”“你究竟怎么知道是我的?“她问。他回答道“夫人,任何一个园艺家都会告诉你,不到五月不要种牵牛花。”不过还有一个谜题。这是影片的第一幕,这是影片的最后一幕。你发现变化了吗?例如,侦探的大衣完全不同了,花也变化了,事实上尸体已经换了衣服并且他的脚抬起到了空中,他的膝盖弯起来了等等。我们没注意到的变化有成千上万。所以发生了什么?为什么我们没有看到这么多变化。宏观解释是,我们从第一幕和最后一幕提取的主旨是相同的,这个主旨就是一座豪宅的客厅里有管家、女仆、侦探和地板着躺着的人。同时拍摄者也非常聪明,他没有向你展示转场画面。镜头从第一幕切到女仆,然后切到管家和Smythe夫人,以剪切的方式,所以你没有看到转场。事实上当你看到影片结尾时你已经或多或少忘记了影片开始,而只记得主旨了。
对盲视的宏观解释为:从长时记忆处理器到短时记忆的支路断开了。非注意盲视的宏观解释是:由于我们给自己关注的物体高权重,给不重要的目标低权重。在变化盲视中,原因是我们给出的主旨。我们没有发现变化是因为第一幅图到最后一幅图的主旨是相同的。
意识的感受与见解
为什么一个信息块带来的意识被定义为接收广播的过程呢?
一个信息块的广播本身并不能神奇地使CTM感受到这个信息块的意识。接收广播只是刚刚开始产生有意识的感觉,但这也不是让CTM真正感受到意识的全部原因。还有什么呢?其中一大部分便是处理器在接收到信息块的广播之后相互之间产生的沟通。Blum夫妇认为CTM之所以对这个被广播的信息块感受到意识觉察是因为相互连接的无意识处理器在接收到信息块后用无意识的大脑语言进行沟通。为什么?到何种程度?让我们假设有一个非常重要的信息块,权重远高于之前的所有信息块,在STM的竞争中获胜。这个信息块被广播出去。当处理器接收到这个重要的信息块,他们开始各自按照自己的方式运作来决定是否作出回应。他们向所有和他们关联的处理器发送相关信息,并且从同一批处理器接收相关信息。他们认为正是处理器对信息块的注意力,也就是处理器关注信息块并察觉其他处理器对信息块的看法这一过程,真正给CTM带来了意识的感觉。
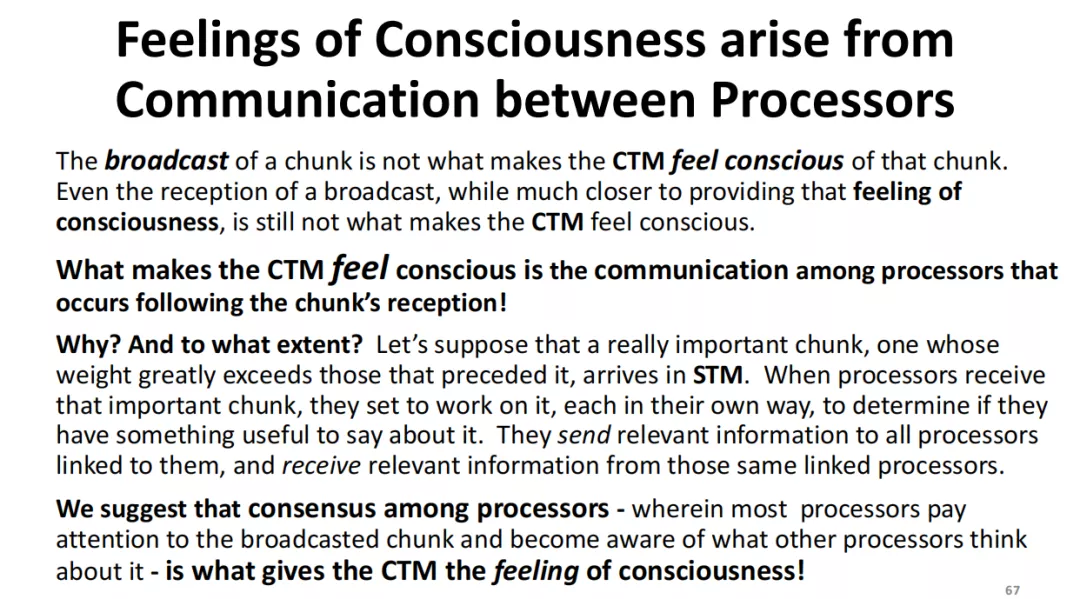
有意识的感觉一部分是从处理器之间无意识的沟通中产生的。上述解释对处理器高度连接的成熟CTM适用,而一个新生的CTM只有很少的连接,甚至没有。这些连接是在CTM逐渐成熟的过程中产生的。一个几乎没有连接的婴儿CTM拥有意识的原理和成熟CTM不同。在婴儿CTM中,处理器用各自的方式处理收到的信息,除了被广播的信息,对其他处理器在做的事毫不知情。相对于成熟CTM,新生CTM的处理器相互之间更加独立。新生CTM,因为它的处理器之间连接更少,相互更独立,可以处理很多不同的想法,这种独立使得处理器在处理任何想法时会受到更少的信息。总而言之,新生CTM可以对很多想法有意识。而成熟CTM更专注于单一想法。
处理器是如何组合的?在新生CTM中有好几个分组,青少年CTM分组少一些,数量少但更大的处理器分组,而在成熟CTM中很多处理器都互相连接了。
科学能否解释感质?
科学可以很好地解释有生和无生命世界。但是科学能否解释感质呢?比如,红酒的口感,晚霞的颜色,头疼的痛感,和初恋的痴迷?很多人认为,我们需要一种新的科学去理解感质的感觉。他们认为当今的科学并不能解释感质的感觉。而我们并不这么认为。我们认为科学,如我们所知,可以解释感质,并不需要引入新的力量。也不需要魔法和玄学。
我们认为科学可以解释感觉是如何产生的,像愉悦和疼痛,无论是在血肉,动物,还是硅和金属构成的机器人身上。什么能算是一种解释?我们在寻找神经回路图和意识的神经关联以外的解释,但最好仍然是包含这些知识的,因为通过描述它的电路和与感觉相关的子回路,我们会更接近解释计算机是怎么拥有意识的。我们在寻找生物化学原理和其效果以外的解释,像控制快感的多巴胺,控制情绪的血清素,和控制兴奋的谷氨酸盐,因为这种解释就像通过描述信号代码和对应效果来解释机器的感觉。我们在寻找的是能同时解释动物的感质和机器的感质的论点。我们认为在未来机器也能拥有感觉。
我们尤其想理解是什么生成了疼痛和愉悦的感觉。疼痛的折磨和喜悦的痴迷都需要一种解释,如果它们是这样一种谜题就好了。这个谜题是,一种机制,也就是我们的身体,是如何产生感觉的?要理解这个问题,让我们先研究一下一种叫示痛不能的症状。
当一个人撞到头之后,他可能产生示痛不能的症状,这意味着他们不会从痛觉中感受到痛苦。他们从过去的经历中知道什么是疼痛,但是他们不会对疼痛感到痛苦。他们可以经受烫伤,冻伤,撞伤,割伤,所有这些都会导致疼痛,但并不会对此感到痛苦。示痛不能的患者仍然声称他们有痛觉。他们清晰地知道疼痛的位置和类型,是热还是冷,但表达说并无大碍。所以示痛不能患者脑子里到底缺少了什么?
特定处理器
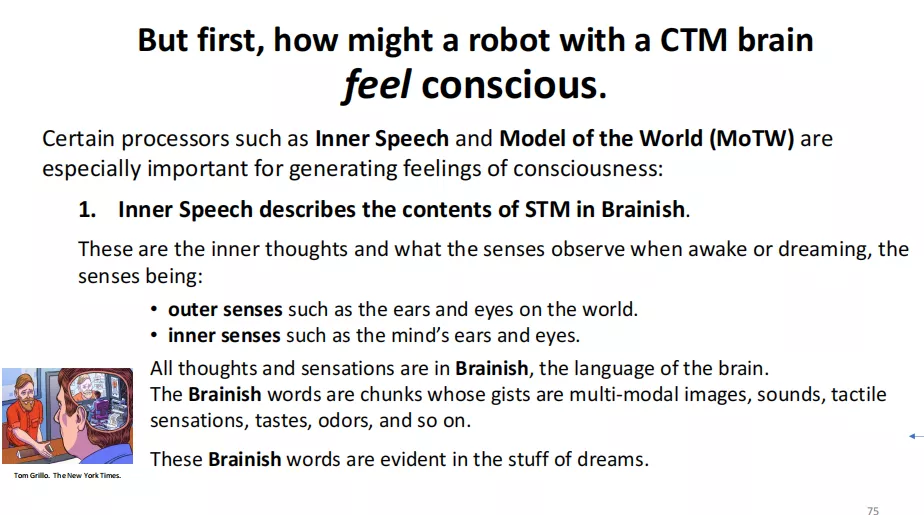
一个拥有CTM大脑的机器人应该怎么感觉到意识?特定处理器,如内在语言处理器和世界模型处理器,在产生意识的感觉方面尤其重要。
首先,内在语言处理器会用大脑语言描述短时记忆里的内容。这包括脑内的想法和感官在清醒或梦境时观察到的东西,其中感官包括外部感官比如观察世界的耳朵和眼睛,以及内部感官比如我们思维的耳朵和眼睛。所有想法和感知都是用大脑语言表达的。大脑的词汇就是信息块,它的主旨是多模态的图像,声音,触感,口味,气味,等等。这些大脑词汇在梦中尤为明显。
我们刚刚聊了内在语言。第二个就是维持环境和实体模型的世界模型处理器。这里实体就是CTM控制的机器人。随着实体在世界中移动,世界模型处理器也不断修改和替换它的世界模型.每个模型都会包含实体本身,包括手臂,腿,等等,用来在世界中移动以及操控世界中的物体。世界模型将我和非我区分开来。当有疼痛时,它会追踪每个疼痛的类型和位置。
机器人到底为什么一定要感受到疼痛?
至少有三个原因
第一个和动物会感到痛苦的理由一样,天生对疼痛不感到痛苦的动物不会活很久,这些幼崽通常很难生存超过3年。
第二,我们希望机器人有共情能力。如果没有亲身感受过,人类很难理解一种新的感觉。
第三,为了对人类和动物的疼痛有更深入的理解。
一个有CTM大脑的机器人是怎么感受疼痛的。
对于极度疼痛我们提出三种解释。
第一个是广播,极度疼痛是一个占据了整个短时记忆的演员。它阻止任何其他演员登上舞台。有且只有疼痛信息能被广播。每个处理器都知道了疼痛。除了痛苦,几乎没有任何信息能进入短时记忆。这里有些证据,在一些通常导致极大痛苦的情况下,示痛不能的人能正常思考而普通人不能。在达尔文主义的构想中,你可能认为疼痛会带来建设性思考,但极度疼痛实际上会干扰建设性思考。它迫使你去依赖你的无意识自我。然而,尽管广播能解释部分疼痛,这仍不能解释突发的剧痛,比如韧带撕裂。这该怎么解释呢?
第二是中断,突发的剧痛,当手指触碰一个点着的炉子时,所有无意识处理器都被中断了。中断与广播有所不同,告知所有长时记忆处理器停止手头的工作,迫使它们把全部注意力集中到引发中断的事件上。广播则是把信息发送给处理器但并不强迫它们停止当前的工作。
第三是大脑语言,处理器之间用于沟通的多模态语言。处理器可以把疼痛大喊出来。它们的喊叫可以将多种模态的语言结合起来。
这些概念该怎样被检验?比如说,如果我们能利用这些概念赋予我们超能力,例如忍受剧痛的能力,那么我们的方向就没错。比如根管治疗,在CTM中,当有无法忍受的疼痛时,没有任何其他东西能进入STM。但是我呢,如果我让牙医在进行根管治疗时不要给我上麻醉药。当他的电钻触碰到我的神经时,我仍然可以思考让他停止。我可以,我确实也大声叫停了。所以我失败了。所以我不认为我们已经找到了最终的答案。
尽管如此,我们确实相信CTM为各种现象提供了非常简洁的解释。CTM就可以帮助人们理解到底发生了什么。有些处理器说你可以的,这个声明抵达了STM并被广播开来。所有处理器便都听到了。
继续检验CTM,正向和负向的情绪是否应该互相抵消?
当小孩磕破了膝盖,很疼。这是母亲亲吻了孩子,这样能缓解吗?能。那膝盖还疼吗?疼。在CTM中,因为f等于情绪的绝对值,负面情绪如磕破膝盖和正面情绪如母亲亲吻完全互相抵消了。两者都没有抵达意识。人类也遵从这个原理吗?我们不这么认为。我们认为两者只是部分抵消。
我们将竞争函数正式定义为一个将信息块映射到非负实数的函数f。这个竞争函数f有且只有一个用途,就是决定两个子节点中哪个可以到达父节点。在确定性CTM中,f值更大的那个子节点得以到达父节点。这种情况下,二号子节点可以上行因为f(2)等于5,大于f(1)的3。在我们认为是正解的概率性CTM中,谁能向上是由概率决定的。子节点1向上的概率是f(1)/(f(1)+f(2))。典型的竞争函数有,f(信息块)=强度。这个f是加性的,意味着f(x+y) = f(x) + f(y)。它被用在很多例子中,有着很多优秀的特性。f(信息块)=|情绪|是一个非加性的竞争函数,这是因为x+y的绝对值不等于x的绝对值加上y的绝对值。尽管如此它仍然被用在很多例子上,但是因为一些原因并不是一个好的竞争函数。
f(信息块)=(1+位置)是一个非加性竞争函数,这个罕见的f将位置最高的信息块放入STM。明显可以看出为什么位置是不是加性的。父节点的位置等于其中一个子节点的位置,所以它不可能是两个子节点位置的和。
接下来我们来解释为什么情绪的绝对值不是一个好的竞争函数,而强度加上一定比例的情绪更好。首先,假设f是情绪的绝对值,这样有些问题。
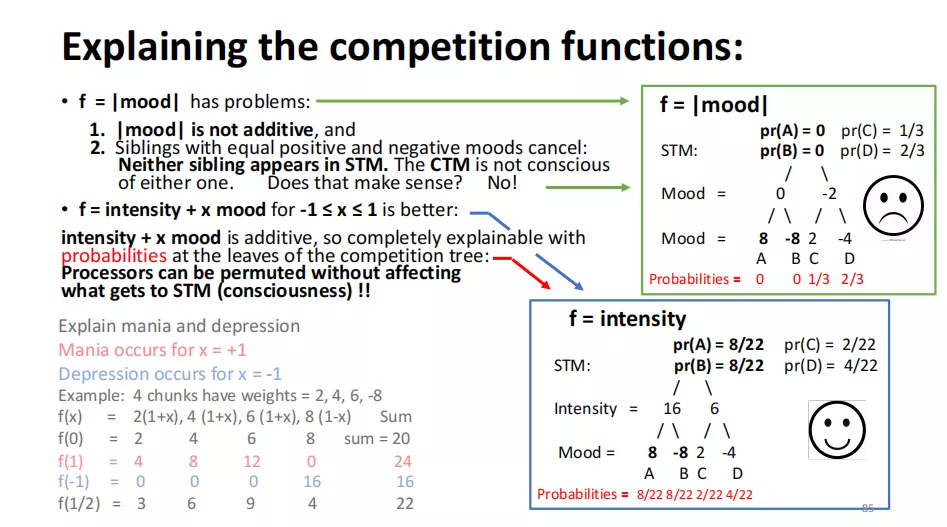
主要的问题是,拥有相等的正向和负向情绪的子节点会互相抵消,两者都不会出现在STM中。CTM对任何一个都毫无意识。这合理吗?比如说,如果你在街上发现了一张10欧元的纸币,这在现实生活中几乎不会碰到。哇,太好了。但是当你弯腰试图捡起来时你擦伤了你的膝盖。嗷,太疼了。你应该对两者都是有意识的,或者两者互相反复交替。但你不会对两者都无意识。然而在CTM中,CTM对A和B都没有意识。f等于强度加上一定比例的情绪就更好。
首先,它是加性的,所以到底什么能到达STM,用竞争树上叶节点的概率是完全可解释的。这也意味着就算按任意顺序重新排列处理器,到达STM的内容也不会被影响.显然在这个情况下,信息块A的概率由强度除以所有强度的和决定,也就是8/22,超过1/3。B也超过1/3。C和D加起来都少于总数的1/3。
当x取极值为+1或-1时会发生另外一件有趣的事。当x=+1时,你会处于狂躁状态,当x=-1时,你会处于抑郁状态。
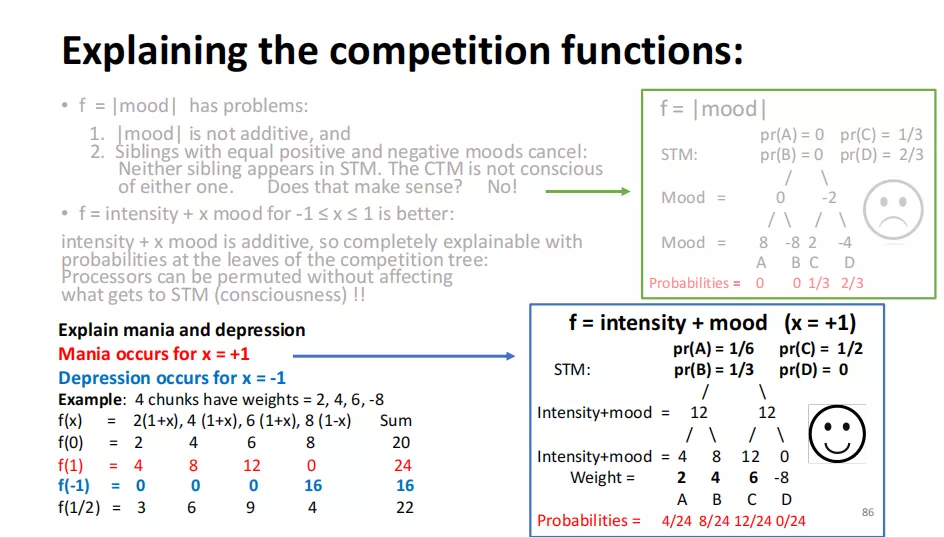
比如,假设你有4个信息块,权重分别为2,4,6和-8。当x=+1时,4,8,12会出现在STM,而-8绝对不会出现,概率为0。如果x=-1,那么任何正向的都会以概率0出现。出现在STM里的会是那个权重为负,强度最大且权重为负的信息块。在这个例子里就是权重-8的D。
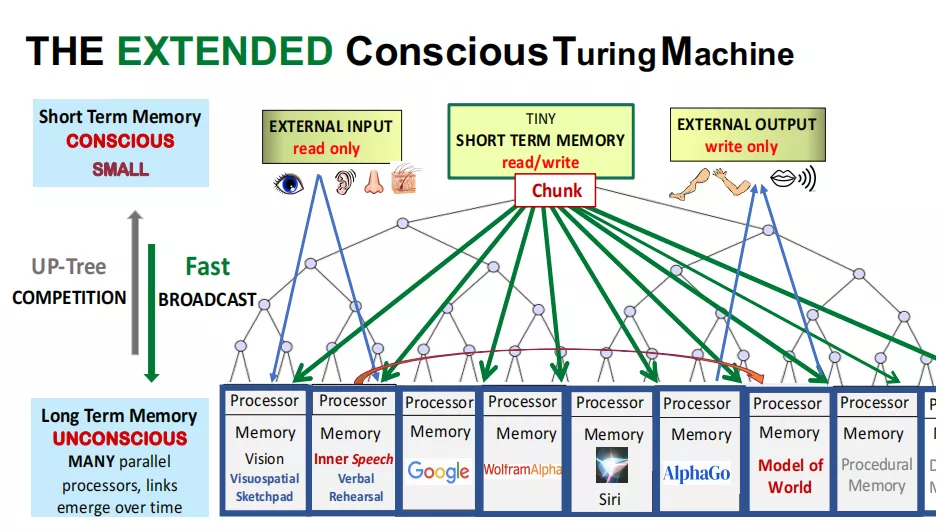
最后分享一个扩展意识图灵机的设计图.它结合了Blum夫妇能找到的最好的最智能的长时记忆处理器!
 微信公众号
 沪公网安备 31011002000007号