

许多人坚信,人工智能的到来,让我们进入了第四次工业革命
华院计算技术(上海)股份有限公司(以下简称“华院计算”)大模型算法负责人蔡华博士受邀出席此次大会,并在大模型产学研结合探索的专题环节中,发表了“大语言模型在法律领域的应用探索”的主题演讲。华院计算的法律大语言模型自推出以来,凭借卓越的性能与广泛的应用价值,荣获了多项榜单、奖项,成功赋能法治领域,让正义更高效。因此,本次大会蔡华以此为契机作演讲主题,旨在让更多听众了解华院计算法律大语言模型的应用框架与相关的技术。
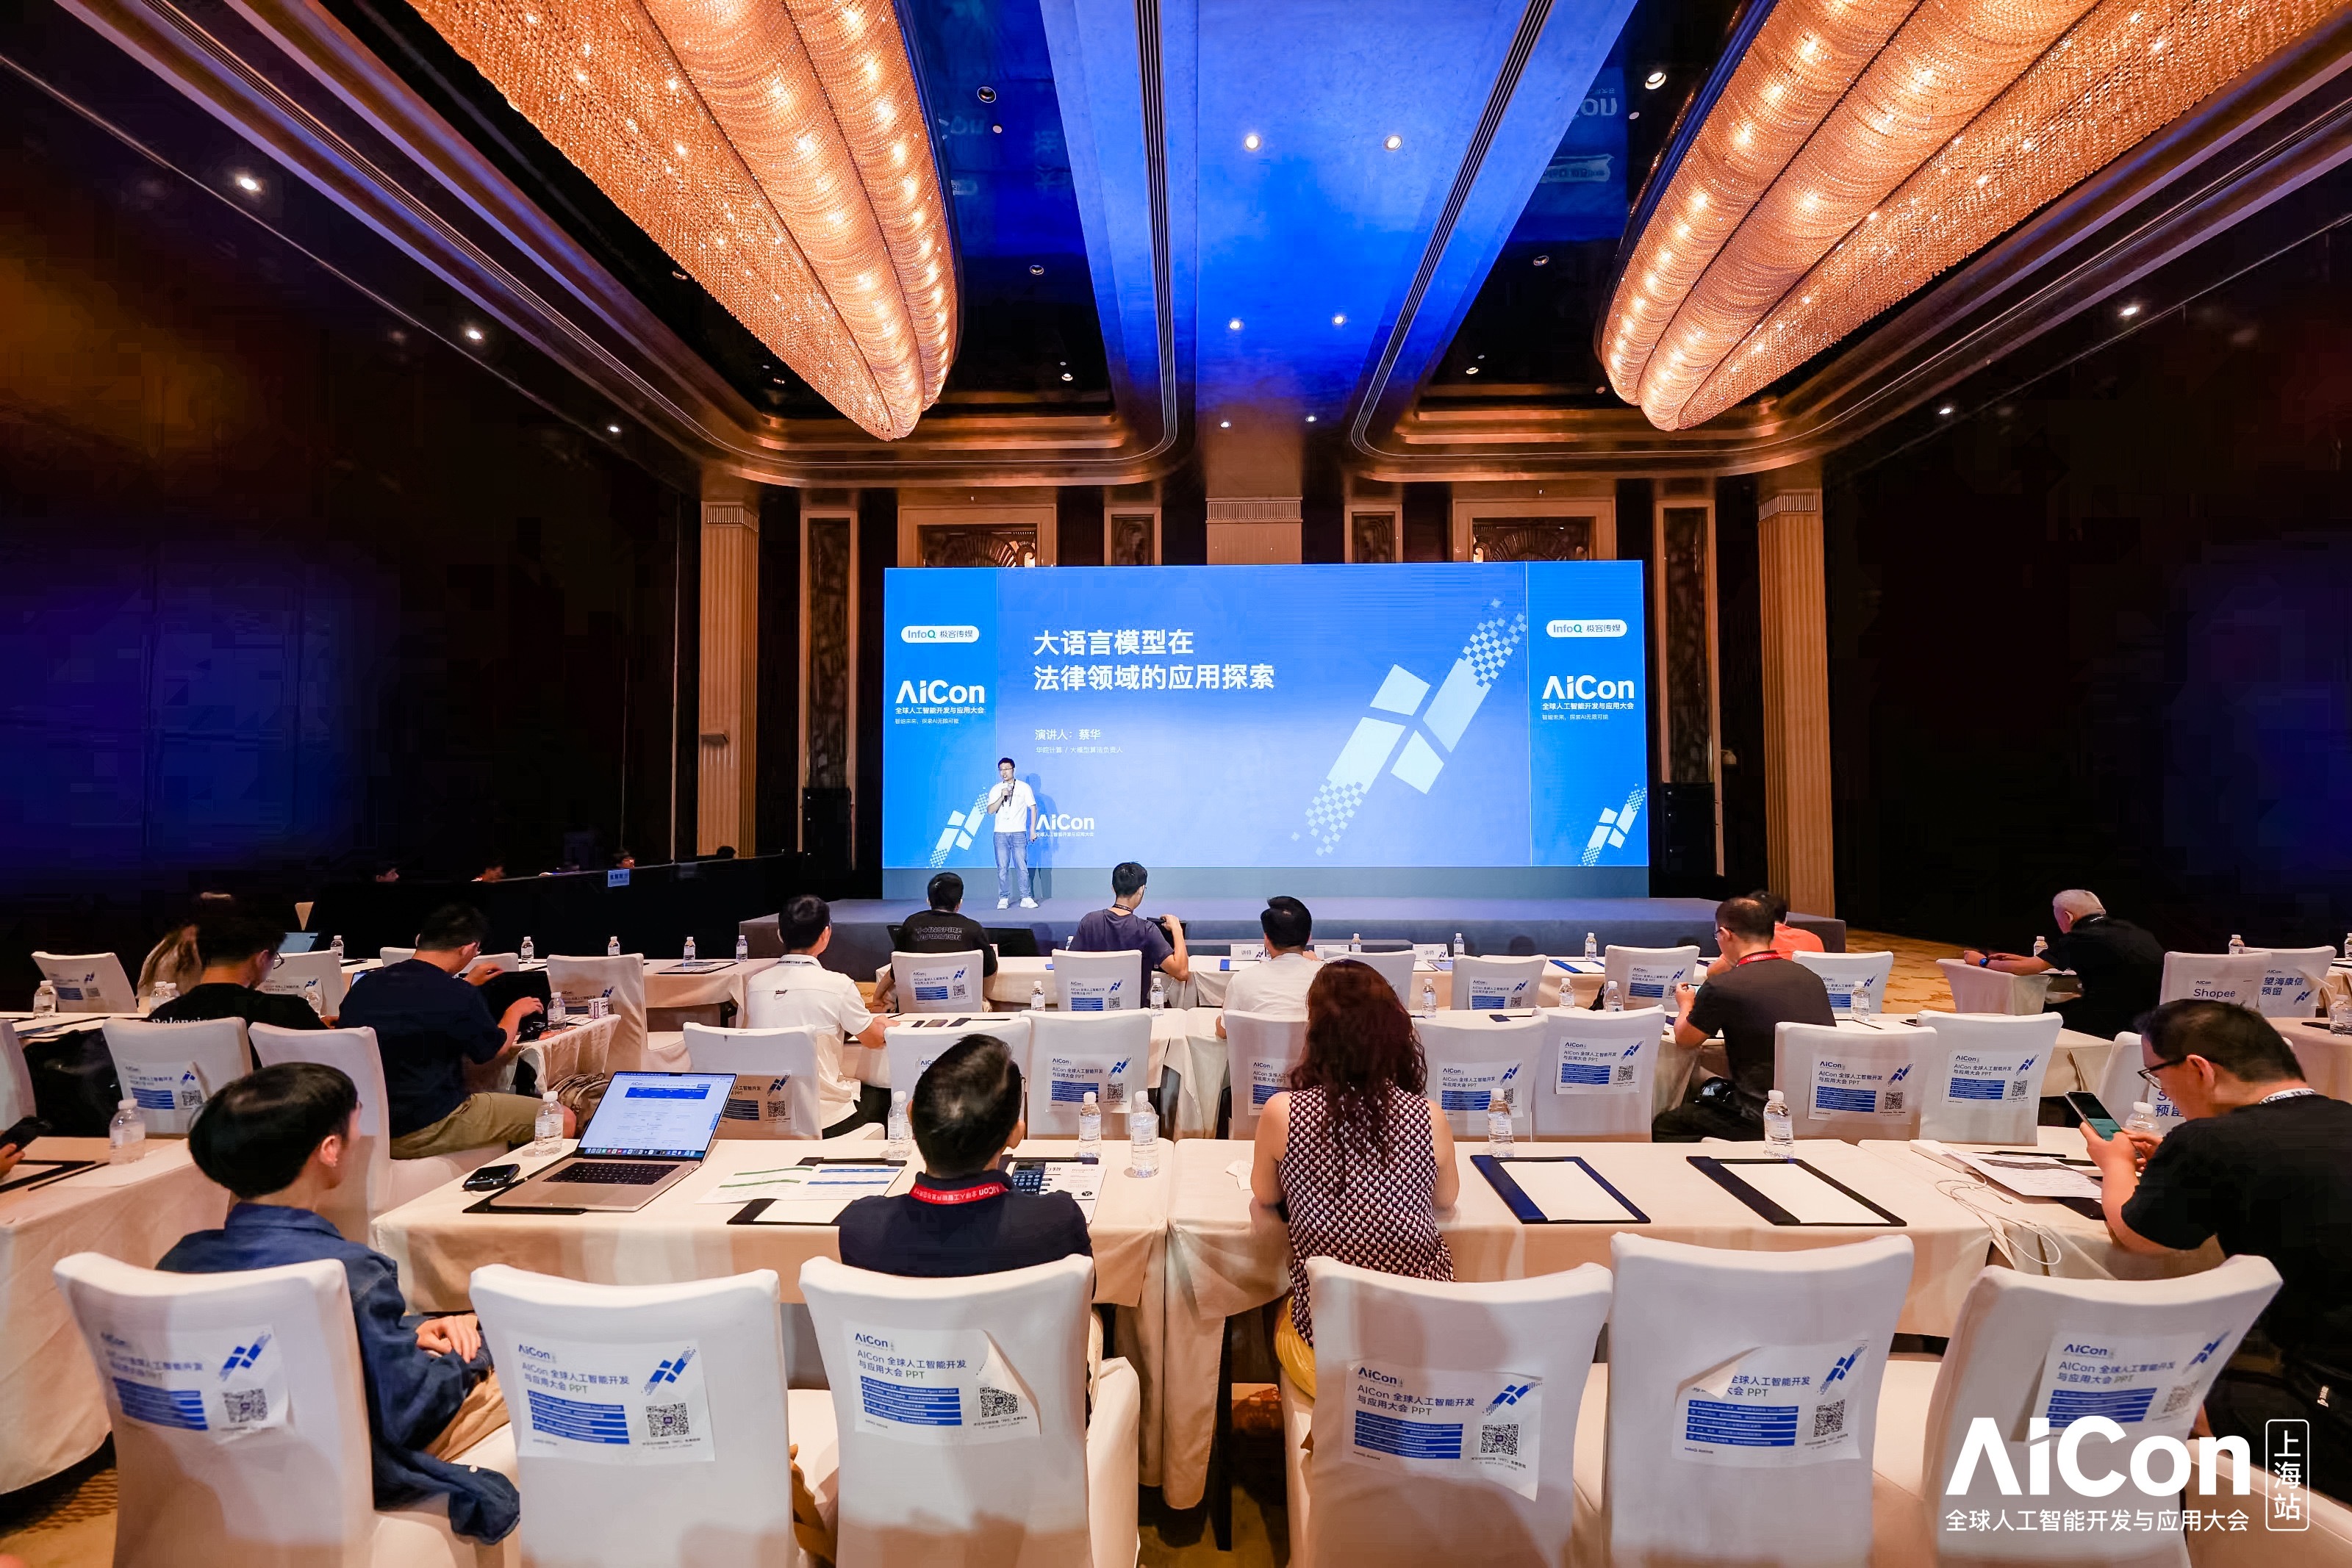
会上,蔡华围绕四大核心议题展开深入阐述:法律大语言模型的相关背景和技术进展,训练和评估方法,技术应用框架以及落地场景与应用。他首先追溯了法律大语言模型的相关背景。从20世纪中叶开始发展的统计语言模型,到20世纪末神经语言模型的突破,再到2017年前后预训练语言模型的推进,直到2020年左右日渐成熟的大规模语言模型。这一连串跨越数十年的技术创新与积累,为华院计算法律大语言模型的诞生与发展提供了坚实的基础。
面对市面上既有的法律大语言模型的局限,如因能力不足无法完成任务、可解释性欠缺及“幻觉”现象频发等挑战,华院计算携手浙江大学与阿里巴巴达摩院
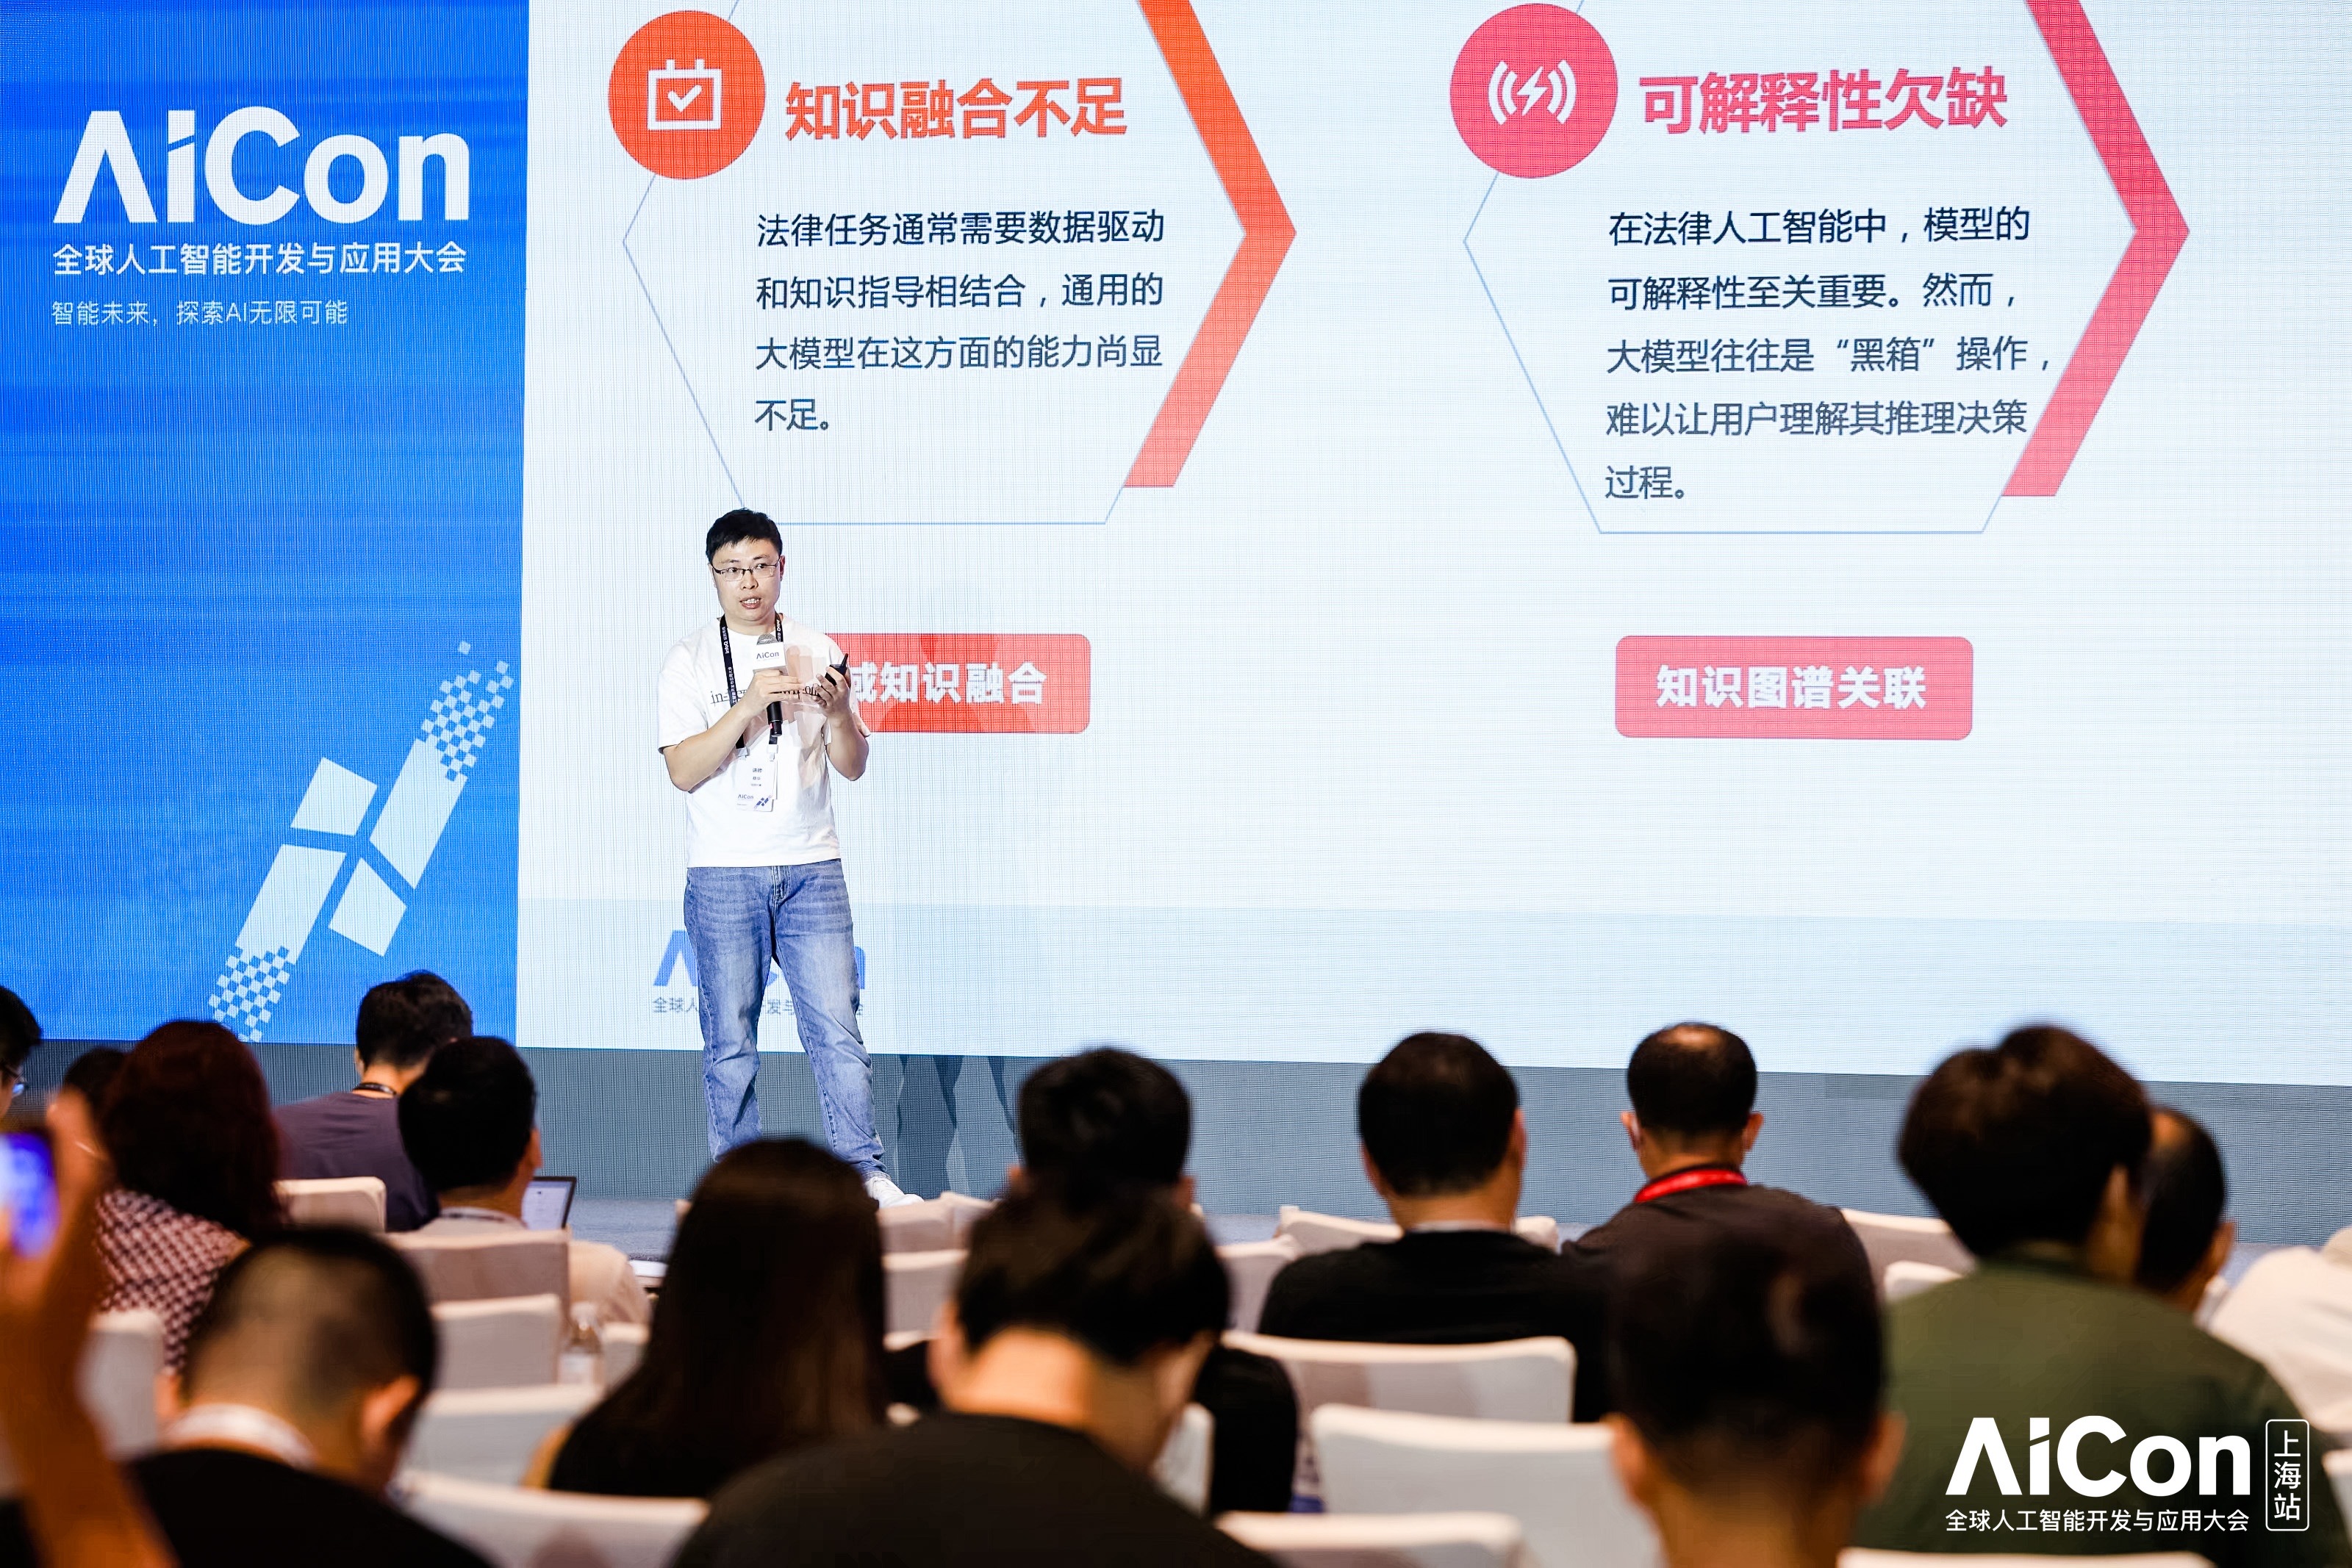
在训练流程上,蔡华也向在场听众详尽阐述了六步法则:(1)进行领域数据的收集;(2)将领域数据进行清洗、筛选和改造;(3)把领域知识数据融入到模型训练中;(4)进行资源需求分析、高效参数调优以达到资源需求的平衡;(5)通过评测指标体系对模型进行迭代优化;(6)最终形成法律大语言模型的能力体系。谈及法律大语言模型的应用框架,他从系统架构的宏观视角,到技术细节的入微剖析,再到华院RAG
最后,蔡华也介绍了法律大语言模型的应用案例,进一步揭示了其强大的功能。他强调,华院计算的法律大语言模型不仅赋能案情分析、法条推荐、法律文书生成及法律问答四大核心领域,更以法律大语言模型为大脑,数智人为载体,构建了集普法宣传、矛盾化解、法律咨询于一体的法律AI助手。这为法律领域提供了更精准的解决方案、提高了法律服务的效率,全面推动法律领域智能化的转型和升级。
 微信公众号
 沪公网安备 31011002000007号